ポリシーリスクを可視化。自然な言葉でポリシーに関する疑問を解決します。 デモを申し込む →
Published:
救急救命士が教えるクラウドインシデントレスポンスの2大ヒント
by Rich Mogull
数多くのユニークな趣味を持つことの利点の一つは、脳の配線が少し変わることです。異なる領域が頭の中で交差して混ざり合い、問題に対して別の角度からアプローチしている自分に気づくでしょう。半ば現役の救急救命士として、私は生身の人間の緊急事態への対応と、ビットとバイトの緊急事態の管理との間に、数え切れないほどの共通点を見出しています。
私はここ数年、クラウドインシデントレスポンスについて数多く教えてきましたが、その中で救急救命の世界の2つのフレーズを使い始めたところ、駆け出しのインシデントレスポンダーによく響くようです。これらの記憶術は、焦点を絞り込み、プロセスを最適化するのに大いに役立ちます。どのようなインシデントレスポンスにも当てはまりますが、主に管理プレーンの存在に起因する本質的な違いのため、クラウド側ではより大きな役割を果たすと感じています。
重症か、重症でないか
救急救命士は一般の人と比べれば多くのことができますが、医療の領域においてはかなり限定的です。私たちは、医学的なものであれ外傷であれ、生命や四肢への脅威を迅速に認識し、患者を安定させて根本的な治療へと搬送するよう、徹底的に訓練されています。私たちに叩き込まれる重要なフレーズの一つが「重症か、重症でないか」です。これは、全体像に集中し、患者が深刻な状態にあるかどうかを見極めることを忘れないための記憶術です。
私はこのフレーズを、情報セキュリティの専門家がインシデントの深刻度を判断する助けとして使うのが気に入っています。クラウドについては、先に進む前にその場で問題に絞り込んで対処する必要がある重大な検出事項を特定するよう教えています。救急医療では、これを「生命への脅威」と呼びます。クラウドインシデントレスポンスは既存のIRスキルを新しい基盤技術に適用するものなので、このフレーズは、通常であればレスポンダーの直感を働かせないような検出事項がもたらす結果を考慮するためのリマインダーにすぎません。いくつか簡単な例を挙げます。
- 公開すべきでないデータがオブジェクトストレージ(S3)で公開されている。
- 管理者権限やその他の高い権限を持つIAMエンティティが侵害された可能性がある。
- 同一の未知のIPアドレスから、異なるIAMユーザーを使用した複数のAPI呼び出しが成功している。
- イメージまたはスナップショットが未知のアカウントとアカウント間で共有されている。
- IAM権限を持つインスタンス/VMが侵害された可能性がある。
こうして書き出すと、ほとんどのレスポンダーは「当たり前じゃないか」と言います。しかし私の経験では、従来型のレスポンダーがこれらの問題を認識し、平均的な侵害された仮想マシンよりもはるかに重大だと理解するには、少し時間が必要です。
クラウドにおける「重症か、重症でないか」は、ほぼ必ず「公開されているか、あるいは攻撃者が管理プレーン(IAM)に入り込んだか」に置き換えられます。
重症か、重症でないか。新たな証拠、パズルの新たなピースを見つけるたびに、これを頭の中で通して、患者が急変しようとしているのか、それとも単に鼻をぐずぐずさせているだけなのかを見極めてください。
出血を止める
多くの方が心肺蘇生法と応急手当の講習を受けたことがあるでしょう。おそらく「ABC」、すなわち気道(Airway)、呼吸(Breathing)、循環(Circulation)を学んだはずです。
ところが、これは実は大きな失敗でした。
研究によって、緊急時に人はABCに集中するあまり、より大きな全体像を見落としてしまうことが明らかになり始めました。救急救命士でさえ、脚の創傷から出血して失血しつつある人にCPRを行っている場面が見られました。時にはそれが完璧なCPRであることもありました。患者の血液がどれだけ速く失われたかで、それがわかるのです。現在では冒頭に「生命への脅威を処置する」を加えており、「出血を止める」が最優先事項となっています。
話の行き先がお分かりでしょうか。
私がこれまで教えてきたすべてのクラスで、経験豊富なレスポンダーが、目の前でクラウドが失血しつつあるにもかかわらず、分析と調査に集中してしまう場面を目にします。なぜでしょうか。
すべてが(潜在的に)インターネット上にあるという状況に慣れていないからです。管理プレーン全体がインターネット上にあるため、攻撃者が認証情報を入手した場合、ファイアウォールやサーバーへのアクセス遮断では止められません。何かが侵害され公開されたなら、それは…要するに、あらゆる場所のあらゆる人に対して、一斉に侵害され公開されたということです。
「出血を止める」は「重症か、重症でないか」と表裏一体です。重症のものを見つけたら、先に進む前にその場で封じ込める必要があるでしょうか。判断を誤れば、攻撃者が進行を続ける間に貴重な時間を浪費しかねないため、これは微妙なバランスです。「出血を止める」とは「これは非常に深刻なので今すぐ対処しなければならない」ということです。ただし出血を止めたら、すぐに元の場所に戻り、分析と対応のプロセスを続ける必要があります。まだ多くの悪意ある活動が進行している可能性があるからです。
私の短いリストはこうです。
- 侵害されたと思われる、高い権限を持つIAMエンティティ。
- 何らかの形で公開されている機密データ。
- 未知の宛先とのアカウント/サブスクリプション/プロジェクト間の共有またはアクセス。
他にもありますが、以上が短いリストです。これらはいずれも、進行中のデータ損失または侵害を示しており、直ちに封じ込める必要があります。
実践での様子
例を示します。スクリーンショットはSlack、AWSコンソール、FireMon Cloud Defenseを組み合わせたものです。これは私のツールチェーンですが、お手元のどのツールでも同様に機能します。トレーニングクラスではSIEMを模擬するためにAthenaクエリも使用しますが、この投稿は(ある程度)短くまとめたいと思います。
CSPMとCDRを統合したプラットフォームからSlackに届いた、中程度の重大度のアラートから始めましょう。
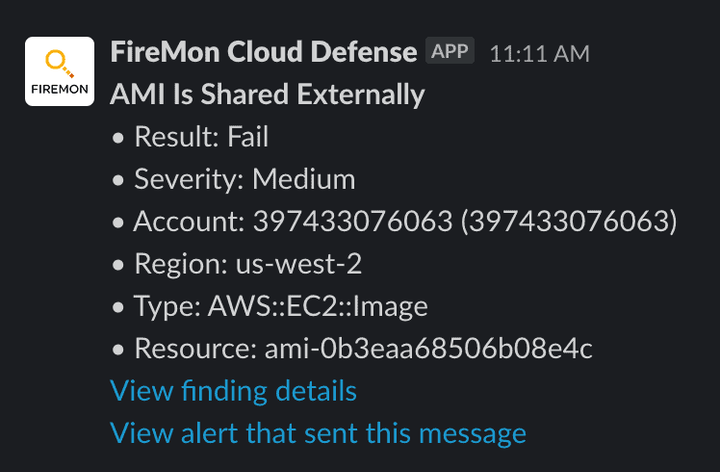
重症か、重症でないか。まだわかりません。まったく正当なものである可能性もあります。では、調査を始めましょう。プラットフォームとAWSコンソールの両方で示します。最初のステップは、何がどこに共有されているかを確認することです。アラートにAMI IDが含まれているので、すぐにそこへ移動できます。
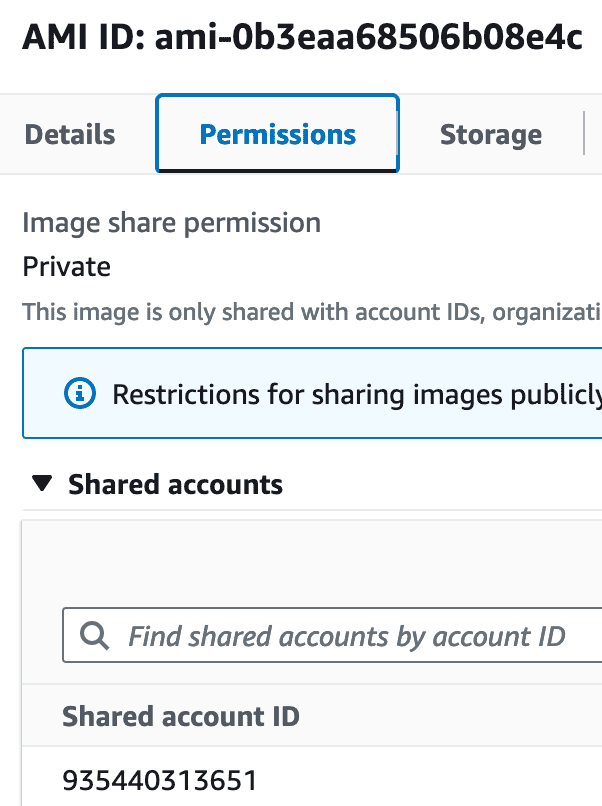
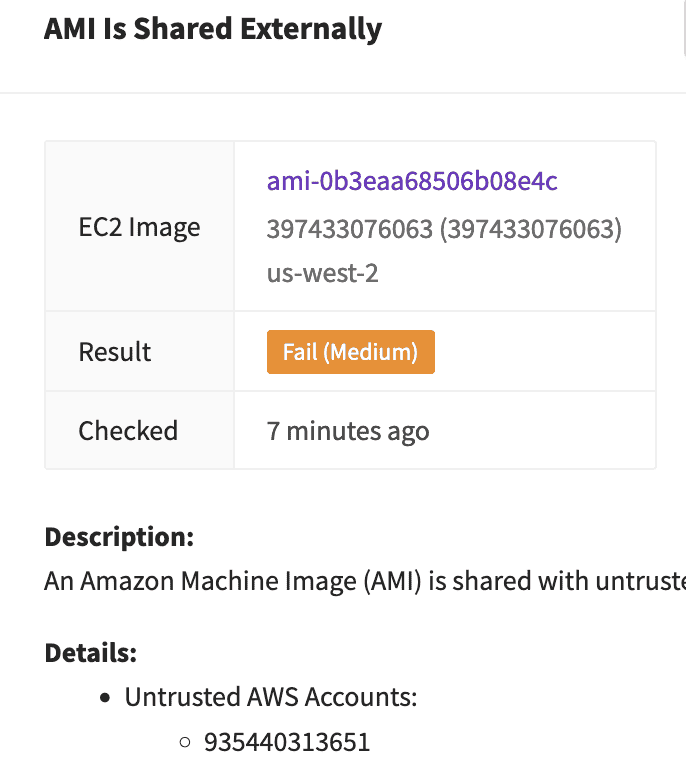
さて、これが別のアカウントと共有されていることがわかりました。それは自分が所有するアカウントでしょうか。知っているアカウントでしょうか。私のツールは、システムに登録されていないアカウントであるため信頼されていないとフラグを立てますが、実際の運用では、念のため組織のマスターアカウント一覧を確認したいところです。
では、重症か、重症でないか。私の頭の中では、まだ「かもしれない」です。信頼されていない可能性のあるアカウントに共有されたイメージがあります。しかし、何が共有されているのかはまだわかりません。元のインスタンスまで遡って追跡する必要があります。完全なフォレンジックを行うつもりはありません。かなり素早く見極める必要があるため、コンテキスト情報に頼ります。今回は運が良かったようです。
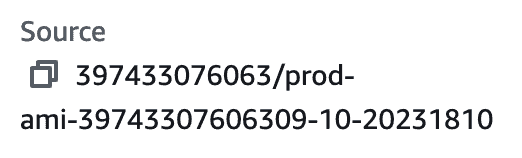
名前に「Prod」が含まれているので…これは「おそらく重症」と判断します。出血を止めるべきか。実際の運用であれば、まずそのAWSアカウントの所有者に連絡を取ろうとするでしょうが、今回はAMIを隔離するのに十分な情報があると考えます。コンソールとCloud Defenseでの手順は次のとおりです。
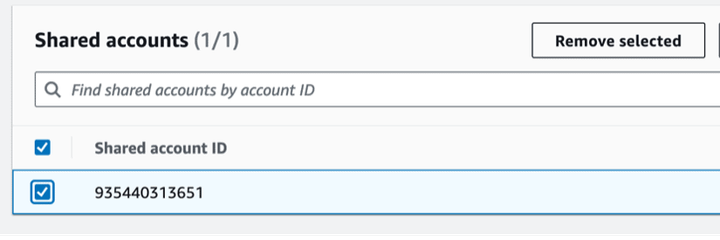
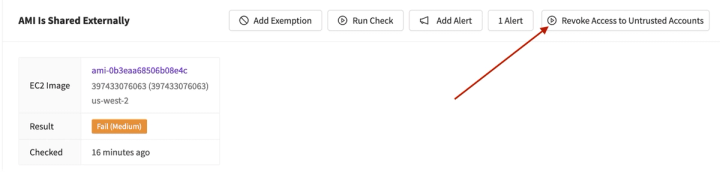
さて、出血を止められたでしょうか。止められたのは…出血の一部です。AMIはロックダウンしましたが、なぜそこに至ったのかはまだわかりません。そのAWSアカウントの所有者もわかりません。突き止められるでしょうか。いいえ。自社のものでなければ、できるのはAWSに報告し、あとは対応を任せることだけです。
では、誰が共有したのか、他に何をしたのかを突き止めるため、API呼び出しを探しましょう。次の部分はプラットフォーム上で行いますが、同じ情報はSIEMやAthenaでクエリを実行して得られます。クエリについては今後の投稿で扱いますが、本稿は「重症」と「出血」の概念に焦点を当てています。
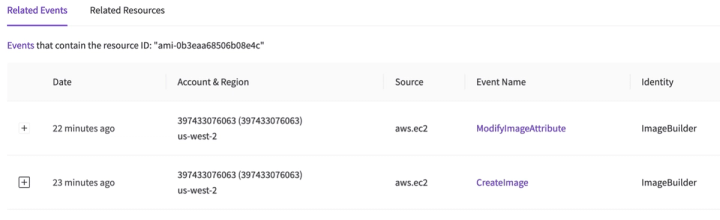
さて、ImageBuilderという名前のIAMエンティティが原因であることがわかりました。この投稿はすでに長くなっているので、いくつか確認した結果、わかったことは次のとおりです。
- ImageBuilderは、イメージの作成とその属性の変更を行う権限を持つIAMユーザーですが、それ以上の権限はありません。ただし、ポリシーにリソースの制約がないため、任意のインスタンスのイメージを作成できます。また条件による制約もないため、任意のアカウントと共有できます。これは中程度から低程度の影響範囲です。過剰な権限ではありますが、ひどいというほどではありません。私はこれを「やや重症」と呼びます。
- API呼び出しは未知のIPアドレスからのものでした。これは疑わしいものの、やはり「やや重症」にとどまります。
- このIAMユーザーがそのIPアドレスを使用したのは初めてであり、このユーザーの過去の活動はバッチ処理と一致しています。ここに来て、「重症」に傾いています。通常、この種のジョブでIPアドレスが入れ替わることはなく、認証情報の流出の臭いがします。
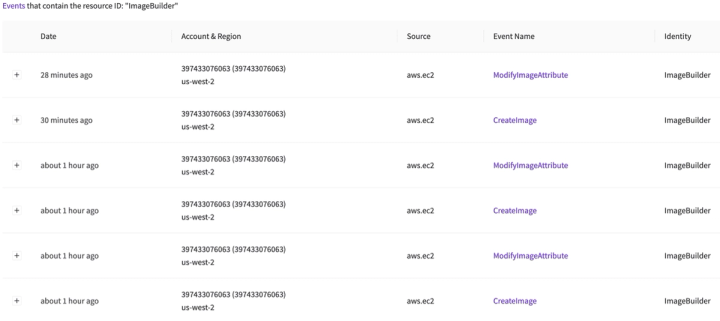
- このIAMユーザーは引き続きこれらの操作を実行できます。意図的に行ったと誰かが言わない限り、私はこれを重症と判断し、出血を止める、そのユーザーアカウントにIAMの制限を課します(重要なプロセスでない限りおそらくDeny Allポリシー、重要な場合はIP制限を使用します)。
まとめると:
- 未知のアカウントに共有されたAMIを発見: 重症
- そのAMIは本番環境の資産のものだった: 重症、そして出血を止める
- その操作は、AMIの作成と共有に関する広範な権限を持つが他には権限のないIAMユーザーによるものだった: 重症かもしれない、調査継続中。
- そのIAMユーザーは未知の新しいIPアドレスからそのAMIを作成した: 重症、(残りの)出血を止める。
- 当該 IP アドレスからの他の検知アクティビティはない: 封じ込められた可能性が高く、すでに Sick ではない
- その認証情報がどのように漏洩したのかは依然として不明である: Sick であり、ネットワーク侵害かホスト侵害かを確認するために、従来型のインシデントレスポンス担当者を呼ぶべき時である。
ここまで駆け足で進めたのは、私がこうした問題をどのように捉えているかをお示しするためです。わずかな違いがあるだけで、この同じ検出結果はまったく正常なものになり得ました。たとえば、それが自社で管理する新しいアカウントと共有されていたものの、まだ登録されていなかっただけだと判明した場合を想像してみてください。あるいは、その AMI が機密情報を一切含まない開発用インスタンスのものだった場合。あるいは、API 呼び出しが自社ネットワークから、想定された時間帯に行われた場合や、管理者のシステムから意図的に共有された場合です。この例は極端なものではありませんが、既知のデータ持ち出しの手口であることに変わりはなく、活動中の脅威アクターによって実際に用いられています。私は情報を一つひとつ把握するたびに、それが Sick か Not Sick か、そして Stop the Bleed が必要かどうかを評価します。
これがクラウドではどう異なるのでしょうか。すべてがインターネットに接する可能性がある以上、リスクはより高くなるからです。私たちはより速く考え、より速く行動する必要があり、この記憶術は軌道を外さないために有用だと感じています。