เข้าใจความเสี่ยงของ policy สอบถามเรื่อง policy ได้ด้วยภาษาทั่วไป ขอชมการสาธิต →
Published:
คดีปริศนาของการเปิดเผยข้อมูลแบบชั่วคราว
by FireMon
แม้เราจะไม่ได้เฝ้าติดตามผลการตรวจพบและการแจ้งเตือนในบัญชีของลูกค้าอย่างต่อเนื่อง แต่เมื่อไม่นานมานี้มีลูกค้ารายหนึ่งติดต่อเข้ามาเพื่อขอให้เรามีบทบาทเชิงรุกมากขึ้นในเส้นทางสู่การทำ remediation แบบอัตโนมัติ ตามคำขอของลูกค้า เราจึงเฝ้าดูบางเรื่องอยู่ และแล้ว... ก็มีเรื่องน่าสนใจเกิดขึ้น
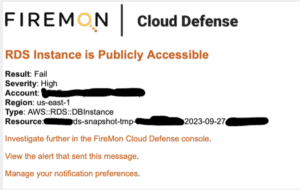
CTO ของเราได้รับการแจ้งเตือนว่ามี RDS instance แบบ public เปิดอยู่ใน AWS แต่เมื่อตรวจสอบกับลูกค้า อินสแตนซ์ดังกล่าวกลับหายไปแล้ว ที่แปลกยิ่งกว่านั้นคือ มีการสร้าง public RDS instance ขึ้นทุกคืน แล้วถูกยกเลิกไปในอีก 50 นาทีต่อมา กิจกรรมลักษณะนี้มีโอกาสหลุดรอดสายตาได้ง่ายหากใช้การประเมินตามรอบเวลา CTO ของเราจึงแจ้งลูกค้าทันที และดึงข้อมูล metadata ของอินสแตนซ์ที่ถูกยกเลิกออกมาจาก inventory ของเรา หลังการตรวจสอบเหตุการณ์ที่เป็นตัวกระตุ้นและคอนฟิกของอินสแตนซ์อย่างละเอียด (และรวดเร็ว ใช้เวลาเพียงไม่กี่นาที) เขาพบว่ามีการสร้างอินสแตนซ์แบบ public ขึ้นทุกคืนจาก snapshot backup ล่าสุดของฐานข้อมูลอีกชุดหนึ่ง จากนั้นจึงเปิดให้เข้าถึงได้จากรายการ IP address ขององค์กรที่รู้จักเพียงไม่กี่รายการ (ซึ่งถือเป็นข่าวดี) ก่อนจะถูกยกเลิกในเวลาไม่นานหลังจากนั้น
การสืบสวน
ลูกค้าได้ตรวจสอบด้วยตนเองและพบว่า นี่เป็นส่วนหนึ่งของกระบวนการอัตโนมัติสำหรับ ETL ที่รันอยู่ในดาต้าเซ็นเตอร์ โดยมี scheduled job ฝั่งคลาวด์ทำหน้าที่สร้างอินสแตนซ์ชั่วคราวแบบ public จำกัดการเข้าถึงไว้เพียงไม่กี่ IP address (5 รายการ ซึ่งก็ยังถือว่าเยอะอยู่ดี) จากนั้นดาต้าเซ็นเตอร์จึงเชื่อมต่อเข้ามาเพื่อดึงข้อมูลออกไป เราไม่เคยทราบว่าการแปลงข้อมูลจริงเกิดขึ้นที่ใด แต่ประเด็นนั้นก็ไม่ได้เกี่ยวข้องกับสถานการณ์นี้มากนัก
เรื่องนี้กลายเป็นโจทย์ที่น่าสนใจสำหรับทีมความปลอดภัย การแจ้งเตือนนั้นถูกต้อง แต่ไม่ได้มีปัญหาด้านความปลอดภัยเกิดขึ้นจริง (แม้จะมีวิธีที่ปลอดภัยกว่าการใช้ public RDS instance อยู่หลายวิธีก็ตาม) การยกเว้นอินสแตนซ์นั้นทำไม่ได้ เพราะมีการสร้างอินสแตนซ์ใหม่ขึ้นทุกคืน การยกเว้นทั้งบัญชีจากการตรวจสอบก็เสี่ยงเช่นกัน เพราะอาจทำให้มองข้าม RDS instance ที่เปิดเผยออกสู่ภายนอกจริง ๆ แม้แต่การยกเว้นตาม tag ก็ยังมีความเสี่ยง เพราะใครก็สามารถเปลี่ยนกระบวนการให้เปิดอินสแตนซ์สู่ IP address ที่ไม่น่าเชื่อถือได้โดยง่าย
บทเรียนที่ได้รับ
คำแนะนำของผมคือ ให้มุ่งแก้ไขที่ตัวกระบวนการต้นทาง แทนที่จะไปทำให้ฝั่งการประเมินซับซ้อนขึ้น ความจริงคือกระบวนการนี้ไม่เหมาะสมในเชิงวิธีปฏิบัติ การอนุญาตให้มี public RDS instance ไม่ใช่แนวทางที่ดีเลย บางครั้งคุณอาจจำเป็นต้องใช้ แต่ควรเป็นทางเลือกสุดท้ายเท่านั้น สิ่งที่ควรทำคือวางอินสแตนซ์ไว้ใน private subnet และเข้าถึงผ่านการเชื่อมต่อเฉพาะหรือผ่าน VPN จากจุดที่คุณต้องการ
แม้เหตุการณ์นี้จะไม่ใช่การเปิดเผยข้อมูลด้านความปลอดภัยจริง แต่ก็ยังมีบทเรียนที่น่าสนใจอยู่ ประการแรก ผมเรียกกรณีนี้ว่า "false false positive" เพราะการแจ้งเตือนเกิดจากเงื่อนไขที่มีอยู่จริงและต้องให้ความสนใจ แต่ไม่จำเป็นต้องก่อความเสี่ยงในสถานการณ์เฉพาะนี้ ไม่มีข้อมูลรั่วไหลจริง แต่ลูกค้าก็ไม่มีทางรู้ได้เลยหากไม่ตรวจสอบและสื่อสารกับทีมที่รับผิดชอบทรัพยากรและกระบวนการดังกล่าว
ประการที่สอง กรณีนี้ป้องกันได้ยากมากด้วย Service Control Policies เพราะไม่มี condition key สำหรับป้องกันการสร้าง public RDS instance และไม่มี condition key สำหรับป้องกันการเปิดพอร์ตฐานข้อมูล (หรือพอร์ตใด ๆ) ใน security group
ประการที่สาม ด้วยลักษณะชั่วคราวของอินสแตนซ์เหล่านี้ หากคุณไม่ได้ตรวจสอบแบบเรียลไทม์หรือในรอบที่สั้นมาก คุณก็อาจพลาดการเปิดเผยข้อมูลนี้ไป ผมพูดถึงหัวข้อนี้ในการอบรม incident response ของผมด้วย เพราะมีหลายสถานการณ์ที่บางสิ่งถูกเปิดเผยและถูกดึงข้อมูลออกไปภายในกรอบเวลาสั้น ๆ แล้วถูกทำลายทิ้งในภายหลังเพื่อลบหลักฐาน นี่คือเหตุผลที่ทีม incident response ต้องมีความสามารถในการเข้าถึง deployment ได้โดยตรงเสมอ และควรเข้าถึง inventory ที่ย้อนดูข้อมูลในอดีตได้ (เช่น AWS Config หรือเครื่องมือจากผู้ให้บริการภายนอกอย่างของเรา) ลำพังการดู API call อาจไม่เพียงพอที่จะเข้าใจว่าเกิดอะไรขึ้น เพราะขาดบริบท ในกรณีนี้ คุณจะตรวจพบการเปิดเผย แต่ยังต้องเข้าไปดูที่ DB Instance โดยตรง (หรือดูใน inventory) เพื่อทราบว่ามีพอร์ตใดเปิดอยู่และเปิดให้ใครบ้าง
ประการที่สี่ เมื่อทางเลือกในการป้องกันมีจำกัด จึงต้องอาศัยมาตรการควบคุมเชิงตรวจจับและเชิงแก้ไข ในกรณีนี้ คุณสามารถตรวจจับ API call CreateDBInstance ได้โดยตรง และตรวจสอบพารามิเตอร์ PubliclyAccessible=True นอกจากนี้ ขอแนะนำอย่างยิ่งให้เฝ้าระวัง Public RDS Instance อย่างต่อเนื่องด้วย CSPM (อีกครั้ง ไม่ว่าจะจาก CSP ของคุณเองหรือจากผู้ให้บริการอย่างเรา) ในด้าน remediation ทางเลือกหนึ่งคือยกเลิกอินสแตนซ์ทันทีที่ตรวจพบการสร้าง แต่แนวทางที่ดีกว่าอาจเป็นการใช้ ModifyDBInstance เพื่อลบพารามิเตอร์ PubliclyAccessible ออก หากคุณทำเช่นนี้ สิ่งสำคัญคือต้องใช้ระบบอัตโนมัติแบบนี้เฉพาะใน deployment ที่คุณมั่นใจว่าจะไม่อนุญาตให้มี public RDS instance เท่านั้น เพราะวันที่คุณไปตัดการเชื่อมต่อฐานข้อมูลที่ได้รับอนุญาตและใช้งานมา 3 ปี เพียงเพราะคุณไม่ได้สื่อสารกับทีมที่เกี่ยวข้อง ก็คงเป็นวันที่ควรหยิบเรซูเม่ออกมาปัดฝุ่น
ท้ายที่สุด เหตุการณ์นี้ไม่ได้ก่อความเสี่ยงด้านความปลอดภัยต่อลูกค้า แต่ก็ชี้ให้เห็นถึงความจำเป็นในการมีกระบวนการที่ปลอดภัยยิ่งขึ้น และขณะนี้ลูกค้าก็กำลังพิจารณาทางเลือกในการดำเนินการที่ปลอดภัยกว่าเดิมอยู่ ผมมองว่าตัวอย่างนี้น่าสนใจเป็นพิเศษ เพราะการเปิดเผย การรั่วไหล และการลักลอบนำข้อมูลออกแบบชั่วคราวเป็นความเสี่ยงที่เกิดขึ้นได้จริง และสิ่งที่เราพบในตอนแรกก็แทบแยกไม่ออกจากการโจมตีจริง กว่าจะรู้ว่าเป็นส่วนหนึ่งของกระบวนการปกติ ทั้งเราและทีมความปลอดภัยของลูกค้าก็ต้องเจาะลึกลงไปก่อน จึงเป็นเรื่องสำคัญที่ต้องทำงานใกล้ชิดกับทีมของคุณเพื่อสร้างแนวปฏิบัติที่ดี ทำให้มั่นใจว่าการเฝ้าระวังของคุณรับมือกับความผันผวนสูงของคลาวด์ได้ และตระหนักว่าเมื่อเกิดเรื่องผิดปกติเช่นนี้ขึ้น การประสานกับผู้ที่รับผิดชอบ deployment นั้นคือสิ่งที่ขาดไม่ได้
บนคลาวด์ บางครั้งวิธีเดียวที่จะแยกแยะระหว่าง false positive กับปัญหาร้ายแรงจริง ๆ คือการสอบถามผู้ที่เกี่ยวข้องโดยตรง ดังที่ผมเขียนไว้ใน Schrödinger’s Misconfigurations ผู้โจมตีใช้ API call เดียวกัน และน่าเสียดายที่ใช้ identity เดียวกันด้วย แทนที่จะพึ่งพาช่องโหว่ zero-day แต่อย่างใด
วิทยากรรับเชิญ
Rich Mogull
SVP of Cloud Security, FireMon
Rich ดำรงตำแหน่ง SVP of Cloud Security ที่ FireMon โดยรับผิดชอบงานวิจัยและการนำเทคโนโลยีด้านความปลอดภัยบนคลาวด์ระดับแนวหน้าไปใช้งานจริง เขาเข้าร่วมกับ FireMon ผ่านการเข้าซื้อกิจการ DisruptOps แพลตฟอร์มระบบอัตโนมัติด้านความปลอดภัยบนคลาวด์ที่พัฒนาขึ้นจากงานวิจัยของเขาในช่วงที่ดำรงตำแหน่ง CEO ของ Securosis เขามีประสบการณ์ด้านความปลอดภัยมากกว่า 25 ปี ปัจจุบันเชี่ยวชาญด้าน cloud security และ DevSecOps โดยเริ่มลงมือทำงานกับคลาวด์โดยตรงมาเกือบ 10 ปี ก่อนก่อตั้ง Securosis และ DisruptOps นั้น Rich เคยเป็น Research Vice President ในทีมความปลอดภัยของ Gartner