Comprenez le risque lié aux politiques. Posez vos questions sur les politiques en langage courant. Demander une démo →
Published:
L’étrange affaire de l’exposition éphémère de données
by FireMon
Même si nous ne surveillons pas activement les comptes de nos clients à la recherche de constats et d’alertes, l’un d’eux nous a récemment sollicités pour jouer un rôle plus proactif dans sa démarche de remédiation automatisée. À sa demande, nous surveillions quelques éléments lorsque… il s’est produit quelque chose d’intéressant.
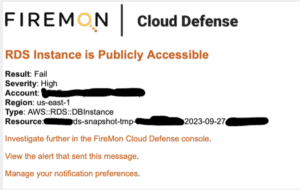
Notre CTO a reçu une alerte signalant la présence d’une instance RDS publique exposée dans AWS. Pourtant, lorsqu’il a vérifié auprès du client, elle avait disparu. Plus étrange encore, une instance RDS publique était créée chaque nuit, pour être supprimée 50 minutes plus tard. Ce type d’activité peut facilement passer inaperçu lors d’évaluations planifiées. Notre CTO en a immédiatement informé le client et a récupéré les métadonnées de l’instance supprimée dans notre inventaire. Après une investigation approfondie (et rapide, elle n’a pris que quelques minutes) des événements déclencheurs et de la configuration de l’instance, il a découvert qu’une instance publique était créée chaque nuit à partir du dernier instantané de sauvegarde d’une autre base de données. Elle était ensuite exposée à une courte liste d’adresses IP d’entreprise connues (bonne nouvelle) avant d’être supprimée peu après.
L’investigation
Le client a mené sa propre investigation et a constaté que cela faisait partie d’un processus d’automatisation ETL exécuté dans le centre de données. Une tâche planifiée côté cloud était chargée de créer l’instance éphémère en mode public, de restreindre l’accès à une poignée d’adresses IP (5, ce qui semblait tout de même beaucoup), puis le centre de données s’y connectait pour extraire les données. Nous n’avons jamais découvert où s’effectuait réellement la transformation des données, mais cela n’a guère d’importance ici.
Cela représentait un défi intéressant pour l’équipe de sécurité : l’alerte était valide, mais il n’y avait aucun véritable problème de sécurité (même s’il existe assurément des moyens plus sûrs de gérer cette situation qu’une instance RDS publique). Exempter l’instance n’était pas envisageable, puisqu’une nouvelle était créée chaque nuit. Exempter l’ensemble du compte du contrôle aurait également été risqué, car cela pourrait conduire à ne pas détecter une instance RDS réellement exposée. Même une exemption fondée sur les balises présentait un risque, car il suffirait de modifier le processus pour exposer l’instance à une adresse IP non fiable.
Enseignements tirés
Mon conseil a été de se concentrer sur la correction du processus sous-jacent plutôt que de complexifier le volet évaluation. En réalité, ce processus n’est pas idéal d’un point de vue procédural : autoriser des instances RDS publiques n’est jamais une bonne pratique. Elles sont parfois nécessaires, mais elles ne devraient constituer qu’un dernier recours. Elles devraient plutôt être placées dans un sous-réseau privé et accessibles via une connexion dédiée ou par VPN depuis l’endroit voulu.
Même si cela ne s’est pas avéré être une exposition de sécurité, plusieurs enseignements intéressants s’en dégagent. Premièrement, je parle ici d’un « faux faux positif », car l’alerte portait sur une condition réelle qui méritait attention, mais ne constituait pas nécessairement un risque dans ce scénario précis. Il n’y a eu aucune fuite de données, mais le client ne pouvait le savoir sans investigation ni échange avec l’équipe responsable de la ressource et du processus.
Deuxièmement, il est difficile de prévenir entièrement ce cas de figure avec des Service Control Policies. Il n’existe pas de clé de condition permettant d’empêcher les instances RDS publiques, pas plus qu’il n’en existe pour empêcher l’ouverture de ports de base de données (ou de tout autre port) dans les groupes de sécurité.
Troisièmement, la nature éphémère des instances signifie que, si vous ne travaillez pas en temps réel ou selon un cycle très court, vous risquez de passer à côté de l’exposition. J’aborde d’ailleurs ce sujet dans ma formation à la réponse à incident, car il existe de nombreuses situations où un élément peut être exposé et extrait dans un laps de temps très court, puis détruit pour effacer les preuves. C’est pourquoi les intervenants en réponse à incident doivent toujours pouvoir accéder directement aux déploiements et disposer d’un inventaire leur permettant de remonter dans le temps (comme AWS Config ou un outil tiers tel que le nôtre). Les appels d’API à eux seuls peuvent ne pas suffire à comprendre ce qui se passe, faute de contexte. Dans ce cas, vous détecteriez l’exposition, mais il faudrait ensuite examiner directement l’instance de base de données (ou l’inventaire) pour voir quels ports sont exposés et depuis où.
Quatrièmement, compte tenu du peu d’options préventives disponibles, il faut recourir à des contrôles de détection et de correction. Dans ce cas, vous pouvez détecter directement l’appel d’API CreateDBInstance et vérifier le paramètre PubliclyAccessible=True. Par ailleurs, une surveillance continue avec un CSPM (là encore, celui de votre CSP ou d’un éditeur comme nous) pour les instances RDS publiques est vivement recommandée. Côté remédiation, une option consiste à supprimer l’instance dès la détection de sa création. Une meilleure approche peut toutefois être d’utiliser ModifyDBInstance pour retirer le paramètre PubliclyAccessible. Si vous procédez ainsi, il est important de n’appliquer une telle automatisation que dans un déploiement où vous êtes certain que les instances RDS publiques ne seront pas autorisées. Le jour où vous interrompez une connexion de base de données attendue et autorisée qui fonctionne depuis 3 ans parce que vous n’avez pas communiqué avec l’équipe est probablement un bon jour pour ressortir votre CV.
En définitive, cet incident n’a pas présenté de risque de sécurité pour le client. Il a toutefois mis en évidence la nécessité de processus plus sûrs, et le client explore activement des options pour procéder de manière plus sécurisée. Je trouve cet exemple particulièrement intéressant, car les expositions, fuites et exfiltrations de données éphémères sont de véritables préoccupations, et ce que nous avons initialement découvert semblait impossible à distinguer d’une attaque réelle. Ce n’est qu’après avoir creusé que nous, ainsi que l’équipe de sécurité du client, avons compris qu’il s’agissait d’un processus attendu. Il est essentiel de travailler en étroite collaboration avec vos équipes pour instaurer de bonnes pratiques, de vous assurer que votre surveillance est capable de gérer la nature très volatile du cloud, et de comprendre que lorsqu’un événement inhabituel de ce type survient, il est crucial d’échanger avec les personnes responsables du déploiement.
Dans le cloud, le seul moyen de distinguer un faux positif d’un problème vraiment grave consiste parfois à se renseigner auprès des personnes directement concernées. Comme je l’écrivais dans Schrödinger’s Misconfigurations, les attaquants utilisent les mêmes appels d’API et, malheureusement, les mêmes identités, plutôt que de s’appuyer sur une quelconque vulnérabilité zero-day.
Intervenant invité
Rich Mogull
SVP Cloud Security, FireMon
Rich est SVP Cloud Security chez FireMon, où il se consacre à la recherche et à la mise en œuvre de solutions de sécurité cloud de pointe. Il a rejoint FireMon lors de l’acquisition de DisruptOps, une plateforme d’automatisation de la sécurité cloud issue de ses travaux de recherche menés alors qu’il était CEO de Securosis. Fort de plus de 25 ans d’expérience en sécurité, il est aujourd’hui spécialisé dans la sécurité cloud et le DevSecOps, après avoir commencé à travailler concrètement dans le cloud il y a près de 10 ans. Avant de fonder Securosis et DisruptOps, Rich était Research Vice President au sein de l’équipe sécurité de Gartner.