Comprenda el riesgo de sus políticas. Haga preguntas sobre políticas en lenguaje natural. Solicitar un demo →
Published:
El misterioso caso de la exposición de datos efímera
by FireMon
Si bien no monitoreamos activamente las cuentas de los clientes en busca de hallazgos y alertas, recientemente un cliente se comunicó con nosotros para que asumiéramos un rol más proactivo en su camino hacia la remediación automatizada. A solicitud del cliente, estábamos vigilando algunos aspectos cuando… ocurrió algo interesante.
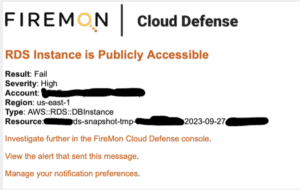
Nuestro CTO recibió una alerta que indicaba que había una instancia RDS pública expuesta en AWS. Sin embargo, cuando lo verificó con el cliente, ya no estaba. Lo más extraño era que cada noche se creaba una instancia RDS pública, solo para ser terminada 50 minutos después. Este tipo de actividad podría pasar desapercibida fácilmente durante evaluaciones programadas. Nuestro CTO informó de inmediato al cliente y recuperó los metadatos de la instancia terminada de nuestro inventario. Tras una investigación exhaustiva (y rápida, solo tomó unos minutos) de los eventos desencadenantes y la configuración de la instancia, descubrió que cada noche se creaba una instancia pública a partir de la copia de seguridad de snapshot más reciente de una base de datos distinta. Luego se exponía a una pequeña lista de direcciones IP corporativas conocidas (lo cual era una buena noticia) antes de ser terminada poco después.
La investigación
El cliente realizó su propia investigación y encontró que esto formaba parte de un proceso de automatización de ETL que se ejecutaba en el centro de datos. Un trabajo programado del lado del cloud era responsable de crear la instancia efímera como pública, restringir el acceso a un puñado de direcciones IP (5, lo que aún parecía mucho), y luego el centro de datos se conectaba para extraer los datos. Nunca averiguamos dónde ocurría la transformación real de los datos, pero eso no es demasiado relevante para la situación.
Esto representó un desafío interesante para el equipo de seguridad: la alerta era válida, pero no había un problema de seguridad real (aunque ciertamente existen formas más seguras de manejar esta situación que una instancia RDS pública). Exceptuar la instancia no era una opción, ya que cada noche se creaba una nueva. Exceptuar toda la cuenta de la verificación también sería riesgoso, pues podría llevar a pasar por alto una instancia RDS genuinamente expuesta. Incluso exceptuar con base en etiquetas implicaba un riesgo, ya que alguien podría cambiar fácilmente el proceso para exponer la instancia a una dirección IP no confiable.
Lecciones aprendidas
Mi consejo fue centrarse en corregir el proceso subyacente en lugar de complicar el lado de la evaluación. La realidad es que este proceso no es ideal desde el punto de vista procedimental: permitir instancias RDS públicas nunca es una buena práctica. A veces se necesitan, pero deberían ser solo un último recurso. En cambio, deberían ubicarse en una subred privada y accederse mediante una conexión dedicada o basada en VPN desde donde se requiera.
Aunque esto no resultó ser una exposición de seguridad, todavía hay algunas lecciones interesantes que aprender. Primero, me refiero a esto como un "falso falso positivo", ya que la alerta correspondía a una condición real que requería atención, pero no necesariamente representaba un riesgo en este escenario en particular. No hubo fuga real de datos, pero el cliente no podía saberlo sin una investigación y sin comunicarse con el equipo responsable del recurso y del proceso.
Segundo, este es un caso difícil de prevenir por completo con Service Control Policies. No existe una clave de condición para impedir instancias RDS públicas, ni tampoco claves de condición para impedir la apertura de puertos de base de datos (o de cualquier puerto) en los grupos de seguridad.
Tercero, la naturaleza efímera de las instancias significa que, a menos que opere en tiempo real o en ciclos muy cortos, podría pasar por alto la exposición. De hecho, cubro este tema en mi capacitación de respuesta a incidentes, ya que hay muchas situaciones en las que algo puede exponerse y extraerse en un lapso muy breve, para luego ser destruido y eliminar la evidencia. Por eso los responsables de respuesta a incidentes siempre necesitan la capacidad de entrar directamente a los despliegues y deben tener acceso a un inventario que les permita mirar hacia atrás (como AWS Config o una herramienta de terceros como la nuestra). Las llamadas a la API por sí solas pueden no ofrecer visibilidad suficiente sobre lo que está ocurriendo, ya que carecen de contexto. En este caso, usted detectaría la exposición, pero luego tendría que revisar directamente la instancia de base de datos (o el inventario) para ver qué puertos están expuestos y desde dónde.
Cuarto, debido a las opciones preventivas limitadas disponibles, deben utilizarse controles detectivos y correctivos. En este caso, puede detectar directamente la llamada a la API CreateDBInstance y verificar el parámetro PubliclyAccessible=True. Además, se recomienda encarecidamente el monitoreo continuo con CSPM (nuevamente, de su CSP o de un proveedor como nosotros) para detectar instancias RDS públicas. En cuanto a la remediación, una opción es terminar la instancia al detectar su creación. Sin embargo, un mejor enfoque puede ser usar ModifyDBInstance para eliminar el parámetro PubliclyAccessible. Si hace esto, es importante implementar dicha automatización únicamente en un despliegue donde tenga certeza de que no se permitirán instancias RDS públicas. El día que interrumpa una conexión de base de datos esperada y autorizada que ha estado funcionando durante 3 años porque no se comunicó con el equipo, probablemente sea un buen día para sacar el currículum.
En última instancia, este incidente no representó un riesgo de seguridad para el cliente. Sin embargo, sí puso de relieve la necesidad de procesos más seguros, y están explorando activamente opciones para manejar las cosas de una manera más segura. Este ejemplo me parece especialmente interesante porque las exposiciones, fugas y exfiltraciones de datos efímeras son preocupaciones genuinas, y lo que descubrimos inicialmente parecía indistinguible de un ataque real. Solo después de profundizar nos dimos cuenta, nosotros y el equipo de seguridad del cliente, de que formaba parte de un proceso esperado. Es fundamental trabajar de cerca con sus equipos para cultivar buenos hábitos, asegurar que su monitoreo sea capaz de manejar la naturaleza altamente volátil del cloud, y entender que cuando ocurre algo inusual como esto, es crítico involucrar a las personas responsables del despliegue.
En el cloud, a veces la única forma de diferenciar entre un falso positivo y un problema realmente grave es consultar a quienes están directamente involucrados. Como escribí en Las configuraciones erróneas de Schrödinger, los atacantes utilizan las mismas llamadas a la API y, lamentablemente, las mismas identidades, en lugar de depender de alguna vulnerabilidad de día cero.
Orador invitado
Rich Mogull
SVP de seguridad cloud, FireMon
Rich es el SVP de seguridad cloud en FireMon, donde se enfoca en la investigación e implementación de seguridad cloud de vanguardia. Rich se unió a FireMon a través de la adquisición de DisruptOps, una plataforma de automatización de seguridad cloud basada en su investigación mientras era CEO de Securosis. Tiene más de 25 años de experiencia en seguridad y actualmente se especializa en seguridad cloud y DevSecOps, tras haber comenzado a trabajar de manera práctica en el cloud hace casi 10 años. Antes de fundar Securosis y DisruptOps, Rich fue vicepresidente de investigación en Gartner dentro del equipo de seguridad.