Policy-Risiken verstehen. Fragen zu Policies in natürlicher Sprache stellen. Demo anfragen →
Published:
Der mysteriöse Fall der ephemeren Datenexposition
by FireMon
Auch wenn wir Kundenkonten nicht aktiv auf Findings und Alarme überwachen, hat sich kürzlich ein Kunde an uns gewandt, der sich auf seinem Weg zur automatisierten Behebung eine proaktivere Rolle von uns wünschte. Auf Wunsch des Kunden behielten wir einige Punkte im Auge, als ... etwas Interessantes geschah.
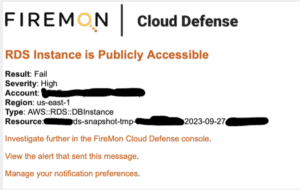
Unser CTO erhielt einen Alarm, der auf eine öffentlich zugängliche RDS-Instanz in AWS hinwies. Als er jedoch beim Kunden nachfragte, war sie nicht mehr vorhanden. Noch merkwürdiger: Jede Nacht wurde eine öffentliche RDS-Instanz erstellt, die 50 Minuten später wieder beendet wurde. Eine solche Aktivität lässt sich bei zeitgesteuerten Assessments leicht übersehen. Unser CTO informierte den Kunden umgehend und rief die Metadaten der beendeten Instanz aus unserem Inventar ab. Nach einer gründlichen (und schnellen, sie dauerte nur wenige Minuten) Untersuchung der auslösenden Ereignisse und der Instanzkonfiguration stellte er fest, dass nächtlich eine öffentliche Instanz auf Basis des letzten Snapshot-Backups einer anderen Datenbank erstellt wurde. Sie wurde dann für eine kurze Liste bekannter Unternehmens-IP-Adressen freigegeben (was eine gute Nachricht war), bevor sie kurz darauf wieder beendet wurde.
Die Untersuchung
Der Kunde führte eine eigene Untersuchung durch und stellte fest, dass dies Teil eines Automatisierungsprozesses für ETL war, der im Rechenzentrum lief. Ein geplanter Job auf Cloud-Seite war dafür verantwortlich, die ephemere Instanz als öffentlich zu erstellen, den Zugriff auf eine Handvoll IP-Adressen zu beschränken (5, was immer noch viel erschien), und anschließend verband sich das Rechenzentrum, um die Daten zu extrahieren. Wo die eigentliche Datentransformation stattfand, haben wir nie herausgefunden, doch das ist für die Situation nicht sonderlich relevant.
Damit stand das Sicherheitsteam vor einer interessanten Herausforderung: Der Alarm war berechtigt, doch es lag kein tatsächliches Sicherheitsproblem vor (auch wenn es sicherlich sicherere Wege gibt, diese Situation zu handhaben, als eine öffentliche RDS-Instanz). Die Instanz auszunehmen, kam nicht infrage, da jede Nacht eine neue erstellt wurde. Das gesamte Konto von der Prüfung auszunehmen, wäre ebenfalls riskant gewesen, da dabei eine tatsächlich exponierte RDS-Instanz übersehen werden könnte. Selbst eine Ausnahme auf Basis von Tags barg ein Risiko, da jemand den Prozess leicht so hätte ändern können, dass die Instanz einer nicht vertrauenswürdigen IP-Adresse zugänglich wird.
Erkenntnisse
Mein Rat lautete, den zugrunde liegenden Prozess zu korrigieren, statt die Assessment-Seite zu verkomplizieren. Tatsache ist, dass dieser Prozess aus verfahrenstechnischer Sicht nicht ideal ist - öffentliche RDS-Instanzen zuzulassen, ist nie guter Stil. Manchmal benötigt man sie, doch sie sollten stets nur die letzte Option sein. Stattdessen sollten sie in einem privaten Subnetz platziert und über eine dedizierte oder VPN-basierte Verbindung von dort aus erreicht werden, wo der Zugriff erforderlich ist.
Auch wenn sich dies nicht als Sicherheitsexposition herausstellte, lassen sich einige interessante Lehren ziehen. Erstens bezeichne ich dies als „falsches False Positive“, da der Alarm einen realen Zustand betraf, der Aufmerksamkeit erforderte, in diesem konkreten Szenario jedoch nicht zwangsläufig ein Risiko darstellte. Es gab keinen tatsächlichen Datenabfluss, doch der Kunde konnte dies ohne Untersuchung und Kommunikation mit dem für die Ressource und den Prozess verantwortlichen Team nicht wissen.
Zweitens lässt sich dies mit Service Control Policies nur schwer vollständig verhindern. Es gibt weder einen Bedingungsschlüssel, um öffentliche RDS-Instanzen zu unterbinden, noch Bedingungsschlüssel, um das Öffnen von Datenbank-Ports (oder beliebigen Ports) in Sicherheitsgruppen zu verhindern.
Drittens bedeutet die ephemere Natur der Instanzen, dass Sie die Exposition möglicherweise übersehen, sofern Sie nicht in Echtzeit oder in sehr kurzen Zyklen arbeiten. Ich behandle dieses Thema auch in meinem Incident-Response-Training, denn es gibt viele Situationen, in denen etwas innerhalb eines engen Zeitfensters exponiert und extrahiert und später wieder zerstört wird, um Spuren zu beseitigen. Deshalb benötigen Incident Responder stets die Möglichkeit, direkt in Deployments einzusteigen, und sollten Zugriff auf ein Inventar haben, das eine rückblickende Analyse erlaubt (etwa AWS Config oder ein Drittanbieter-Tool wie unseres). API-Aufrufe allein liefern möglicherweise keinen ausreichenden Einblick in das Geschehen, da ihnen der Kontext fehlt. In diesem Fall würden Sie die Exposition erkennen, müssten dann aber direkt die DB-Instanz (oder das Inventar) prüfen, um zu sehen, welche Ports von wo aus offen sind.
Viertens müssen angesichts der begrenzten präventiven Möglichkeiten detektive und korrektive Kontrollen eingesetzt werden. In diesem Fall können Sie den API-Aufruf CreateDBInstance direkt erkennen und auf den Parameter PubliclyAccessible=True prüfen. Zusätzlich ist eine kontinuierliche Überwachung öffentlicher RDS-Instanzen mit CSPM (wiederum von Ihrem CSP oder einem Anbieter wie uns) sehr zu empfehlen. Zur Behebung besteht eine Möglichkeit darin, die Instanz zu beenden, sobald ihre Erstellung erkannt wird. Der bessere Ansatz dürfte jedoch sein, mit ModifyDBInstance den Parameter PubliclyAccessible zu entfernen. Wenn Sie so vorgehen, ist es wichtig, eine solche Automatisierung nur in einem Deployment umzusetzen, in dem Sie sicher sind, dass öffentliche RDS-Instanzen nicht zulässig sind. An dem Tag, an dem Sie eine erwartete und autorisierte Datenbankverbindung stören, die seit 3 Jahren läuft, weil Sie die Abstimmung mit dem Team versäumt haben, ist es vermutlich Zeit, den Lebenslauf hervorzuholen.
Letztlich stellte dieser Vorfall kein Sicherheitsrisiko für den Kunden dar. Er machte jedoch den Bedarf an sichereren Prozessen deutlich, und der Kunde prüft derzeit aktiv Möglichkeiten, dies sicherer zu gestalten. Ich finde dieses Beispiel besonders interessant, weil ephemere Datenexpositionen, Leaks und Exfiltration reale Gefahren sind und das, was wir zunächst entdeckten, von einem tatsächlichen Angriff nicht zu unterscheiden schien. Erst nach genauerer Analyse erkannten wir und das Sicherheitsteam des Kunden, dass es sich um Teil eines erwarteten Prozesses handelte. Es ist entscheidend, eng mit Ihren Teams zusammenzuarbeiten, um gute Gewohnheiten zu etablieren, sicherzustellen, dass Ihre Überwachung der hohen Volatilität der Cloud gewachsen ist, und zu verstehen, dass bei solch ungewöhnlichen Vorkommnissen der Austausch mit den für das Deployment Verantwortlichen unverzichtbar ist.
In der Cloud ist der Abgleich mit den direkt Beteiligten manchmal die einzige Möglichkeit, ein False Positive von einem wirklich gravierenden Problem zu unterscheiden. Wie ich in Schrödingers Fehlkonfigurationen geschrieben habe, nutzen Angreifer dieselben API-Aufrufe und leider auch dieselben Identitäten, statt sich auf eine Zero-Day-Schwachstelle zu stützen.
Gastredner
Rich Mogull
SVP of Cloud Security, FireMon
Rich ist SVP of Cloud Security bei FireMon und befasst sich dort schwerpunktmäßig mit modernster Cloud-Security-Forschung und deren Umsetzung. Zu FireMon kam Rich durch die Übernahme von DisruptOps, einer Automatisierungsplattform für Cloud-Sicherheit, die auf seiner Forschung als CEO von Securosis beruht. Er verfügt über mehr als 25 Jahre Erfahrung im Sicherheitsbereich und ist derzeit auf Cloud-Sicherheit und DevSecOps spezialisiert; praktisch in der Cloud arbeitet er seit fast 10 Jahren. Vor der Gründung von Securosis und DisruptOps war Rich Research Vice President im Security-Team von Gartner.