เข้าใจความเสี่ยงของ policy สอบถามเรื่อง policy ได้ด้วยภาษาทั่วไป ขอชมการสาธิต →
Published:
เคล็ดลับ 2 ข้อจาก Paramedic สำหรับ Cloud Incident Response
by Rich Mogull
ข้อดีอย่างหนึ่งของการมีงานอดิเรกที่หลากหลายและไม่เหมือนใครคือมันทำให้สมองเดินคนละแบบ คุณจะพบว่าตัวเองมองปัญหาจากมุมที่ต่างออกไป เพราะความรู้จากคนละแวดวงปะปนกันอยู่ในหัว ในฐานะ Paramedic ที่ยังทำงานอยู่บ้าง ผมเห็นความคล้ายคลึงมากมายระหว่างการรับมือเหตุฉุกเฉินกับร่างกายมนุษย์ และการรับมือเหตุฉุกเฉินในโลกของบิตและไบต์
ตลอดไม่กี่ปีที่ผ่านมา ผมสอนเรื่อง cloud incident response อยู่บ่อยครั้ง และเริ่มหยิบวลีสองวลีจากโลกของ Paramedic มาใช้ ซึ่งดูจะเข้าถึงใจผู้ที่กำลังก้าวเข้าสู่งาน incident response ได้ดี ตัวช่วยจำเหล่านี้ทำหน้าที่จัดระเบียบโฟกัสและทำให้กระบวนการมีประสิทธิภาพยิ่งขึ้น แม้จะใช้ได้กับ incident response ทุกรูปแบบ แต่ผมพบว่ามันมีบทบาทมากกว่าในฝั่งคลาวด์ เพราะความแตกต่างเชิงโครงสร้างที่เกิดจากการมีอยู่ของ management plane เป็นหลัก
Sick or Not Sick
Paramedic ทำอะไรได้มากกว่าคนทั่วไปอยู่พอสมควร แต่ก็ยังมีข้อจำกัดสูงในทางการแพทย์ เราถูกฝึกมาอย่างเข้มข้นให้รู้จักภาวะคุกคามต่อชีวิตและอวัยวะได้อย่างรวดเร็ว ไม่ว่าจะเป็นทางอายุรกรรมหรือการบาดเจ็บ แล้วทำให้ผู้ป่วยคงที่และนำส่งไปยังการรักษาที่ปลายทาง วลีสำคัญที่ถูกตอกย้ำกับเราคือ “sick or not sick” เป็นตัวช่วยจำให้เราโฟกัสที่ภาพรวมและประเมินว่าผู้ป่วยอยู่ในภาวะวิกฤตหรือไม่
ผมชอบใช้วลีนี้ช่วยให้คนทำงาน infosec ประเมินว่าเหตุการณ์หนึ่งรุนแรงแค่ไหน สำหรับคลาวด์ เราสอนให้ระบุสิ่งที่ตรวจพบซึ่งมีนัยสำคัญพอที่จะต้องหยุดจัดการตรงนั้นทันทีก่อนไปต่อ ในงานการแพทย์ฉุกเฉินเราเรียกสิ่งนี้ว่า “life threat” เนื่องจาก cloud incident response ใช้ทักษะ IR เดิมบนเทคโนโลยีพื้นฐานแบบใหม่ วลีนี้จึงเป็นเพียงเครื่องเตือนใจให้พิจารณาผลลัพธ์ของสิ่งที่ตรวจพบ ซึ่งปกติอาจไม่กระตุ้นสัญชาตญาณของผู้รับมือเหตุการณ์ ตัวอย่างง่าย ๆ เช่น
- ข้อมูลใน object storage (S3) ถูกเปิดเป็นสาธารณะทั้งที่ไม่ควรเป็นเช่นนั้น
- IAM entity ที่อาจถูกยึดครอง ซึ่งมีสิทธิ์ admin หรือสิทธิ์สูงอื่น ๆ
- การเรียก API สำเร็จหลายครั้งด้วย IAM user ต่างกัน จาก IP address เดียวกันที่ไม่รู้จัก
- การแชร์ image หรือ snapshot ข้ามบัญชีไปยังบัญชีที่ไม่รู้จัก
- instance/VM ที่อาจถูกยึดครองและมีสิทธิ์ IAM ติดอยู่
เวลาผมเขียนออกมาแบบนี้ ผู้รับมือเหตุการณ์ส่วนใหญ่มักพูดว่า “ก็ชัดเจนอยู่แล้วนี่” แต่จากประสบการณ์ของผม ผู้รับมือเหตุการณ์สายดั้งเดิมต้องใช้เวลาสักพักกว่าจะมองเห็นปัญหาเหล่านี้ และตระหนักว่ามันร้ายแรงกว่าเครื่องเสมือนที่ถูกยึดครองทั่ว ๆ ไปมาก
“Sick or not sick” บนคลาวด์แทบจะหมายถึง “มันเปิดสาธารณะหรือเปล่า หรือผู้โจมตีเข้าไปถึง management plane (IAM) แล้ว” เสมอ
Sick or not sick ทุกครั้งที่คุณเจอหลักฐานชิ้นใหม่ หรือชิ้นส่วนใหม่ของปริศนา ให้ลองคิดผ่านกรอบนี้ในหัวว่าผู้ป่วยของคุณกำลังจะทรุดหนัก หรือแค่เป็นหวัดเล็กน้อย
Stop the Bleed
หลายท่านคงเคยเรียน CPR และปฐมพยาบาลมาบ้าง และน่าจะเคยได้ยิน “ABCs”: Airway, Breathing และ Circulation
ปรากฏว่าเราเข้าใจเรื่องนั้นผิดไปพอสมควร
งานวิจัยเริ่มชี้ว่า ในสถานการณ์ฉุกเฉิน ผู้คนจะจดจ่อกับ ABCs จนมองข้ามภาพรวม แม้แต่ Paramedic ก็ยังเคยถูกจับได้ว่ากำลังทำ CPR ให้กับผู้ป่วยที่เลือดกำลังไหลออกจากบาดแผลที่ขา บางครั้งก็เป็น CPR ที่สมบูรณ์แบบ สังเกตได้จากความเร็วที่เลือดของผู้ป่วยหมดไป ทุกวันนี้เราเพิ่ม “treat life threat” ไว้ข้างหน้า และ “stop the bleed” คือสิ่งที่สำคัญที่สุด
เห็นภาพแล้วใช่ไหมว่าผมกำลังจะพูดถึงอะไร
ในทุกคลาสที่ผมสอน ผมเห็นผู้รับมือเหตุการณ์ที่มีประสบการณ์สูงจดจ่ออยู่กับการวิเคราะห์และสืบสวน ขณะที่คลาวด์กำลังเลือดไหลอยู่ตรงหน้า เพราะอะไร
เพราะพวกเขาไม่คุ้นกับการที่ทุกอย่าง (อาจจะ) อยู่บนอินเทอร์เน็ต management plane ทั้งหมดอยู่บนอินเทอร์เน็ต ดังนั้นถ้าผู้โจมตีได้ credential ไป คุณจะหยุดเขาด้วย firewall หรือด้วยการปิดการเข้าถึงเซิร์ฟเวอร์ไม่ได้ ถ้าบางสิ่งถูกยึดครองและถูกเปิดเผย มันก็ถูกยึดครองและเปิดเผยต่อ… ทุกคน ทุกที่ ในเวลาเดียวกัน
Stop the bleed เดินคู่กันไปกับ sick or not sick ถ้าคุณเจอสิ่งที่ sick คุณจำเป็นต้องควบคุมมันตรงนั้นทันทีก่อนไปต่อหรือไม่ นี่คือการชั่งน้ำหนักที่ละเอียดอ่อน เพราะถ้าตัดสินใจผิด คุณอาจเสียเวลาอันมีค่าไปในขณะที่ผู้โจมตีเดินหน้าต่อ Stop the bleed เท่ากับ “เรื่องนี้แย่พอที่ผมต้องแก้เดี๋ยวนี้” แต่เมื่อหยุดเลือดได้แล้ว คุณต้องกลับไปยังจุดที่ค้างไว้ทันที และเดินหน้ากระบวนการวิเคราะห์และตอบสนองต่อ เพราะอาจยังมีเรื่องร้ายอีกมากเกิดขึ้นอยู่
รายการสั้น ๆ ของผมมีอะไรบ้าง
- IAM entity ใดก็ตามที่มีสิทธิ์สูงและดูเหมือนถูกยึดครอง
- ข้อมูลอ่อนไหวที่เปิดเป็นสาธารณะด้วยเหตุใดก็ตาม
- การแชร์หรือการเข้าถึงข้ามบัญชี/subscription/project ไปยังปลายทางที่ไม่รู้จัก
ยังมีมากกว่านี้ แต่นี่คือรายการสั้น ๆ ทุกข้อบ่งชี้ถึงการสูญเสียข้อมูลหรือการถูกยึดครองที่กำลังเกิดขึ้น และคุณต้องควบคุมมันทันที
ลองดูของจริง
นี่คือตัวอย่าง ภาพหน้าจอเป็นส่วนผสมของ Slack, AWS Console และ FireMon Cloud Defense นั่นคือชุดเครื่องมือของผม และวิธีนี้ใช้ได้กับเครื่องมือใดก็ตามที่คุณมี ในคลาสฝึกอบรม เรายังใช้ Athena queries เพื่อจำลอง SIEM ด้วย แต่ผมอยากให้บทความนี้สั้น (พอประมาณ)
เริ่มจาก alert ระดับปานกลางใน Slack จากแพลตฟอร์ม CSPM/CDR แบบรวมของเรา:
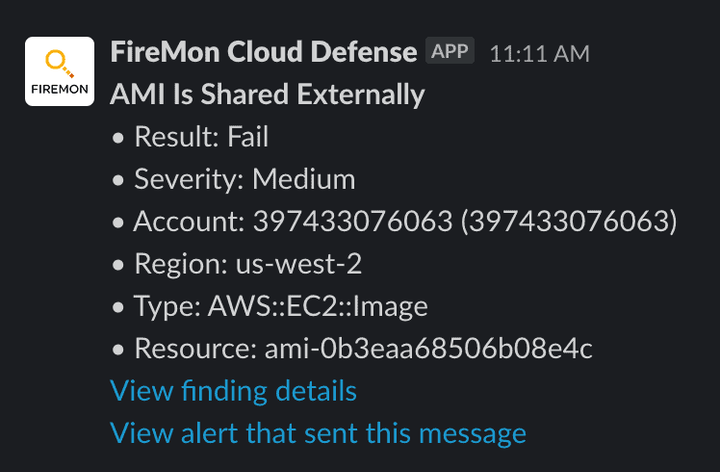
Sick or Not Sick ยังไม่รู้ อาจเป็นเรื่องปกติโดยสมบูรณ์ก็ได้ เอาล่ะ ถึงเวลาสืบสวน ผมจะแสดงทั้งในแพลตฟอร์มและใน AWS console ขั้นแรกคือดูว่ามีอะไรถูกแชร์ไปที่ไหน เนื่องจาก alert ระบุ AMI ID มาแล้ว เราจึงกระโดดไปดูได้เลย:
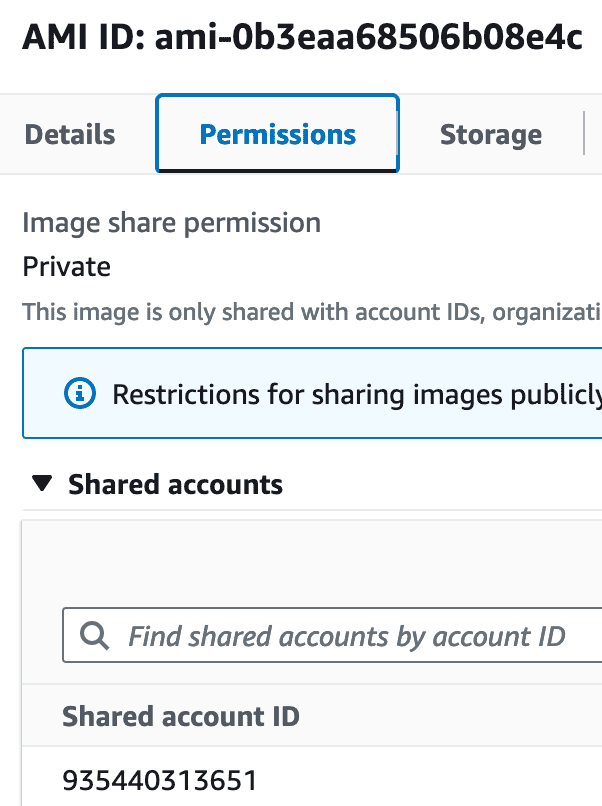
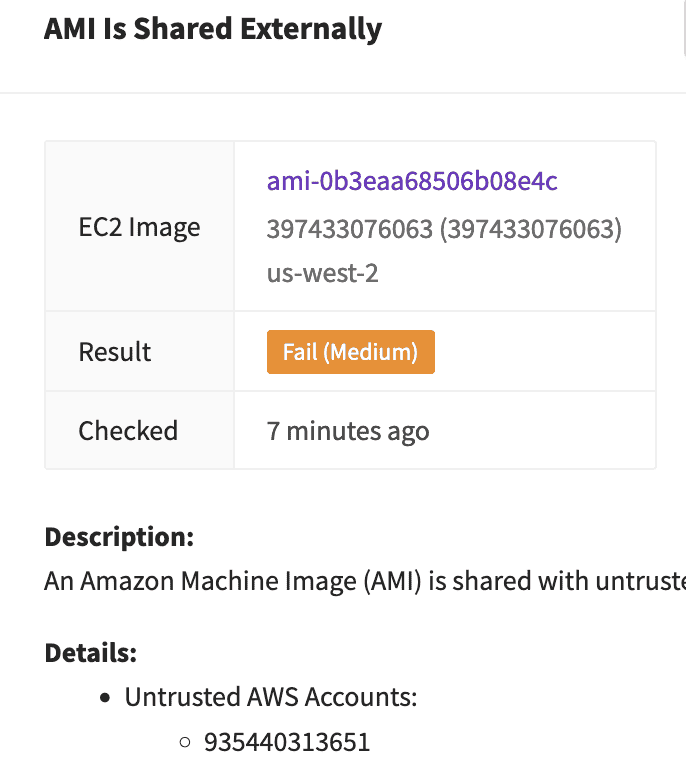
เอาล่ะ ผมเห็นว่ามันถูกแชร์กับอีกบัญชีหนึ่ง บัญชีนั้นเป็นของผมหรือเปล่า เป็นบัญชีที่ผมรู้จักไหม เครื่องมือของผมทำเครื่องหมายว่าไม่น่าเชื่อถือ เพราะไม่ใช่บัญชีที่ลงทะเบียนไว้ในระบบ แต่ในชีวิตจริง ผมจะตรวจสอบรายการบัญชีหลักขององค์กรอีกครั้งเพื่อความแน่ใจ
ทีนี้ sick or not sick ในหัวผมยังตอบว่า “อาจจะ” ผมมี image ที่ถูกแชร์ไปยังบัญชีที่อาจไม่น่าเชื่อถือ แต่ยังไม่รู้ว่าสิ่งที่ถูกแชร์คืออะไร ผมต้องตามรอยกลับไปยัง instance ต้นทาง ผมไม่ลงลึกถึงขั้นทำ forensics เต็มรูปแบบ แต่จะอาศัยข้อมูลเชิงบริบท เพราะต้องหาคำตอบให้เร็ว ในกรณีนี้เราโชคดี:
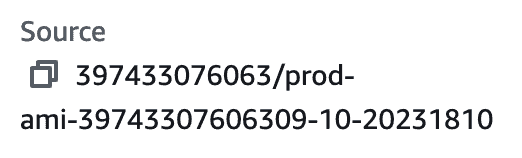
ชื่อมีคำว่า "Prod" อยู่ ดังนั้น… ผมขอเรียกว่า “น่าจะ sick” แล้ว stop the bleed ล่ะ ในชีวิตจริง ผมจะพยายามติดต่อเจ้าของบัญชี AWS นั้นก่อน แต่สำหรับวันนี้ ผมคิดว่ามีข้อมูลเพียงพอที่จะกักกัน AMI ตัวนั้น นี่คือวิธีทำทั้งใน console และใน Cloud Defense:
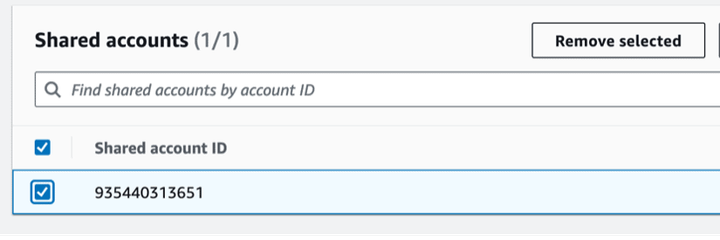
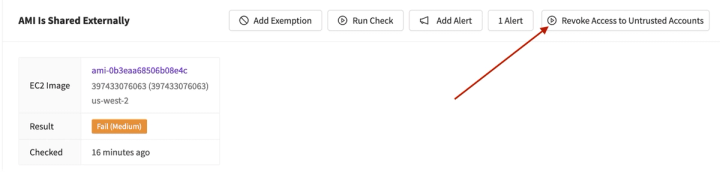
เอาล่ะ เรา Stop the Bleed ได้แล้วหรือยัง เราหยุดได้… เพียงบางส่วน เราล็อก AMI ไว้แล้ว แต่ยังไม่รู้ว่ามันไปอยู่ตรงนั้นได้อย่างไร และยังไม่รู้ว่าใครเป็นเจ้าของบัญชี AWS นั้น เราหาคำตอบได้ไหม ไม่ได้ ถ้าไม่ใช่บัญชีของเรา สิ่งเดียวที่ทำได้คือรายงานไปยัง AWS แล้วให้พวกเขาจัดการต่อ
มาตามล่าการเรียก API กัน เพื่อดูว่าใครเป็นคนแชร์และทำอะไรไว้อีกบ้าง ขั้นตอนต่อไปนี้ผมจะทำในแพลตฟอร์ม แต่คุณสามารถรัน query ใน SIEM หรือ Athena เพื่อหาข้อมูลเดียวกันได้ ผมจะเขียนถึง query ทั้งหมดในบทความถัดไป แต่บทความนี้โฟกัสที่แนวคิด sick/bleed
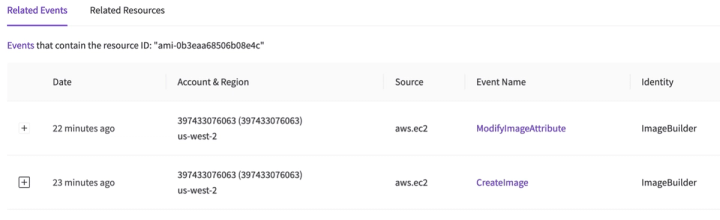
เอาล่ะ ผมเห็นว่า IAM entity ชื่อ ImageBuilder เป็นต้นเหตุ อีกครั้ง เนื่องจากบทความนี้เริ่มยาวแล้ว ผมตรวจสอบบางอย่างไว้ และนี่คือสิ่งที่พบ:
- ImageBuilder เป็น IAM user ที่มีสิทธิ์สร้าง image และแก้ไขคุณสมบัติของ image เท่านั้น แต่ policy ไม่มีข้อจำกัดด้าน resource จึงสร้าง image จาก instance ใดก็ได้ และไม่มีเงื่อนไขจำกัด จึงแชร์ให้บัญชีใดก็ได้ นี่คือ blast radius ระดับปานกลางถึงต่ำ มีสิทธิ์เกินความจำเป็น แต่ยังไม่ถึงขั้นเลวร้าย ผมเรียกว่า ค่อนข้าง sick
- การเรียก API มาจาก IP address ที่ไม่รู้จัก น่าสงสัยอยู่ แต่ยังแค่ค่อนข้าง sick
- นี่เป็นครั้งแรกที่ผมเห็น IAM user รายนี้ใช้ IP address ดังกล่าว และกิจกรรมก่อนหน้าของ user นี้สอดคล้องกับ batch process เอาล่ะ ตอนนี้ผมเอนไปทาง sick แล้ว โดยปกติเราไม่เห็นการสลับ IP address สำหรับงานลักษณะนี้ มันส่อกลิ่นของ credential ที่หลุดออกไป:
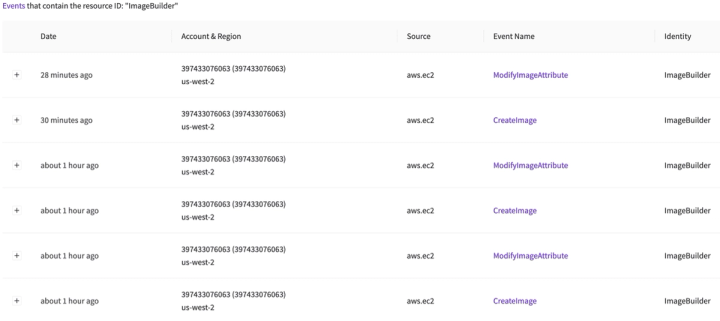
- IAM user รายนั้นยังทำสิ่งเหล่านี้ได้ต่อไป หากไม่มีใครบอกผมว่าตั้งใจทำแบบนี้ ผมขอเรียกว่า Sick และผมจะ Stop the Bleed แล้วใส่ข้อจำกัด IAM ให้กับบัญชี user นั้น (น่าจะเป็น policy แบบ Deny All เว้นแต่จะเป็นกระบวนการสำคัญ ซึ่งกรณีนั้นผมจะใช้ข้อจำกัดด้าน IP แทน)
สรุป:
- ผมพบ AMI ที่ถูกแชร์ไปยังบัญชีที่ไม่รู้จัก: Sick
- AMI นั้นเป็นของสินทรัพย์บน production: Sick และ Stop the Bleed
- การกระทำนี้มาจาก IAM user ที่มีสิทธิ์กว้างในการสร้างและแชร์ AMI แต่ไม่มีสิทธิ์อื่นใด: อาจจะ sick ยังอยู่ระหว่างการสืบสวน.
- IAM user รายนั้นสร้าง AMI ดังกล่าวจาก IP address ใหม่ที่ไม่รู้จัก: Sick, Stop the (rest of the) Bleed.
- ไม่พบกิจกรรมอื่นใดจาก IP address ดังกล่าว: มีแนวโน้มว่าควบคุมสถานการณ์ได้แล้วและไม่อยู่ในภาวะ Sick อีกต่อไป
- ผมยังไม่ทราบว่า credentials เหล่านั้นรั่วไหลออกไปได้อย่างไร: ถือว่า Sick และถึงเวลาเรียกทีม IR แบบดั้งเดิมเข้ามาตรวจสอบว่าเป็นการบุกรุกที่ระดับเครือข่ายหรือระดับโฮสต์
ผมไล่ลำดับอย่างรวดเร็วเพื่อให้เห็นวิธีที่ผมมองปัญหาเหล่านี้ หากรายละเอียดต่างออกไปเพียงเล็กน้อย สิ่งที่ตรวจพบนี้ก็อาจเป็นเรื่องปกติโดยสิ้นเชิง ลองนึกภาพว่าเราพบว่ามีการแชร์ไปยังบัญชีใหม่ที่เราควบคุมอยู่แต่ยังไม่ได้ลงทะเบียน หรือ AMI นั้นเป็นของ instance สำหรับการพัฒนาที่ไม่มีข้อมูลสำคัญอยู่เลย หรือ API calls มาจากเครือข่ายของเราเองในช่วงเวลาที่คาดไว้ หรือมาจากระบบของผู้ดูแลที่ตั้งใจแชร์อยู่แล้ว ตัวอย่างนี้ไม่ได้ร้ายแรงถึงที่สุด แต่เป็นรูปแบบการขโมยข้อมูลออกนอกองค์กรที่รู้จักกันดี ซึ่งถูกใช้โดยผู้โจมตีที่เคลื่อนไหวอยู่จริง ทุกครั้งที่ได้ข้อมูลมาแต่ละชิ้น ผมจะประเมินว่าเป็น Sick หรือ Not Sick และจำเป็นต้อง Stop the Bleed หรือไม่
แล้วบนคลาวด์ต่างออกไปอย่างไร คำตอบคือความเสี่ยงสูงกว่า เพราะทุกสิ่งมีโอกาสเชื่อมต่อกับอินเทอร์เน็ตได้ เราจึงต้องคิดและลงมือให้เร็วขึ้น และผมพบว่าเทคนิคช่วยจำนี้มีประโยชน์ในการทำให้เราไม่หลุดประเด็น