Entenda o risco das políticas. Faça perguntas sobre políticas em linguagem natural. Solicite uma demonstração →
Published:
O caso misterioso da exposição efémera de dados
by FireMon
Embora não monitorizemos ativamente as contas dos clientes em busca de constatações e alertas, recentemente um cliente contactou-nos para que assumíssemos um papel mais proativo no seu percurso rumo à remediação automatizada. A pedido do cliente, estávamos atentos a algumas questões quando... aconteceu algo interessante.
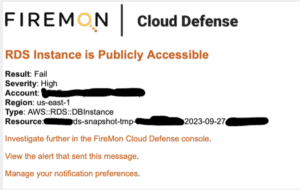
O nosso CTO recebeu um alerta a indicar que existia uma instância RDS pública exposta na AWS. No entanto, quando verificou junto do cliente, já não estava lá. A acrescentar à estranheza, uma instância RDS pública era criada todas as noites, apenas para ser terminada 50 minutos depois. Este tipo de atividade poderia facilmente passar despercebido durante avaliações periódicas. O nosso CTO informou prontamente o cliente e obteve os metadados da instância terminada a partir do nosso inventário. Após uma investigação minuciosa (e rápida, demorou apenas alguns minutos) dos eventos desencadeadores e da configuração da instância, descobriu que era criada todas as noites uma instância pública com base na cópia de segurança mais recente (snapshot) de uma base de dados diferente. Era depois exposta a uma pequena lista de endereços IP corporativos conhecidos (o que era uma boa notícia) antes de ser terminada pouco depois.
A investigação
O cliente conduziu a sua própria investigação e constatou que isto fazia parte de um processo de automatização de ETL executado no centro de dados. Uma tarefa agendada do lado da cloud era responsável por criar a instância efémera como pública, restringindo o acesso a um punhado de endereços IP (5, o que ainda assim parecia muito), e depois o centro de dados ligava-se para extrair os dados. Nunca chegámos a apurar onde ocorria efetivamente a transformação dos dados, mas isso não é particularmente relevante para a situação.
Isto representou um desafio interessante para a equipa de segurança - o alerta era válido, mas não havia qualquer problema de segurança real em causa (embora existam seguramente formas mais seguras de lidar com esta situação do que uma instância RDS pública). Isentar a instância não era uma opção, uma vez que era criada uma nova todas as noites. Isentar toda a conta da verificação também seria arriscado, pois poderia levar a que uma instância RDS genuinamente exposta passasse despercebida. Mesmo a isenção com base em etiquetas representava um risco, já que alguém poderia facilmente alterar o processo para expor a instância a um endereço IP não fidedigno.
Lições aprendidas
O meu conselho foi concentrar esforços na correção do processo subjacente em vez de complicar o lado da avaliação. A realidade é que este processo não é ideal do ponto de vista procedimental - permitir instâncias RDS públicas nunca é boa prática. Por vezes são necessárias, mas devem ser apenas um último recurso. Em alternativa, devem ser colocadas numa sub-rede privada e acedidas através de uma ligação dedicada ou baseada em VPN a partir de onde for necessário.
Embora isto não se tenha revelado uma exposição de segurança, há ainda algumas lições interessantes a retirar. Primeiro, refiro-me a isto como um "falso falso positivo", uma vez que o alerta dizia respeito a uma condição real que exigia atenção, mas que não representava necessariamente um risco neste cenário específico. Não houve qualquer fuga de dados real, mas o cliente não o poderia saber sem uma investigação e sem comunicar com a equipa responsável pelo recurso e pelo processo.
Segundo, este é um caso difícil de prevenir totalmente com Service Control Policies. Não existe qualquer chave de condição para impedir instâncias RDS públicas, nem chaves de condição para impedir a abertura de portas de base de dados (ou de quaisquer portas) em grupos de segurança.
Terceiro, a natureza efémera das instâncias significa que, a menos que opere em tempo real ou num ciclo muito curto, poderá não detetar a exposição. Aliás, abordo este tema na minha formação de resposta a incidentes, pois há muitas situações em que algo pode ser exposto e extraído num intervalo de tempo reduzido, para depois ser destruído de modo a eliminar provas. É por isso que quem responde a incidentes precisa sempre da capacidade de entrar diretamente nas implementações e deve ter acesso a um inventário que lhe permita olhar para trás (como o AWS Config ou uma ferramenta de terceiros como a nossa). As chamadas de API por si só podem não fornecer uma visão suficiente do que está a acontecer, uma vez que lhes falta contexto. Neste caso, detetaria a exposição, mas depois teria de analisar diretamente a instância de BD (ou o inventário) para ver que portas estão expostas e a partir de onde.
Quarto, dadas as opções preventivas limitadas disponíveis, há que recorrer a controlos de deteção e correção. Neste caso, é possível detetar diretamente a chamada de API CreateDBInstance e verificar o parâmetro PubliclyAccessible=True. Além disso, recomenda-se vivamente a monitorização contínua com CSPM (novamente, do seu CSP ou de um fornecedor como nós) para instâncias RDS públicas. Em termos de remediação, uma opção é terminar a instância assim que se detete a sua criação. No entanto, uma abordagem melhor poderá ser utilizar ModifyDBInstance para remover o parâmetro PubliclyAccessible. Se o fizer, é importante implementar tal automatização apenas numa implementação em que tenha a certeza de que não serão permitidas instâncias RDS públicas. O dia em que interromper uma ligação de base de dados esperada e autorizada que funciona há 3 anos por não ter comunicado com a equipa será provavelmente um bom dia para desencantar o currículo.
Em última análise, este incidente não representou um risco de segurança para o cliente. No entanto, evidenciou a necessidade de processos mais seguros, e o cliente está a explorar ativamente opções para lidar com estas situações de forma mais segura. Considero este exemplo particularmente interessante porque as exposições, fugas e exfiltrações efémeras de dados são preocupações reais, e aquilo que inicialmente descobrimos parecia indistinguível de um ataque efetivo. Só depois de aprofundarmos é que nós, e a equipa de segurança do cliente, percebemos que fazia parte de um processo esperado. É fundamental trabalhar em estreita colaboração com as suas equipas para cultivar bons hábitos, garantir que a sua monitorização é capaz de lidar com a natureza altamente volátil da cloud e compreender que, quando algo invulgar como isto acontece, é crítico envolver as pessoas responsáveis pela implementação.
Na cloud, por vezes a única forma de distinguir entre um falso positivo e um problema realmente grave é verificar junto de quem está diretamente envolvido. Como escrevi em Schrödinger’s Misconfigurations, os atacantes utilizam as mesmas chamadas de API e, infelizmente, as mesmas identidades, em vez de recorrerem a alguma vulnerabilidade de dia zero.
Orador convidado
Rich Mogull
SVP of Cloud Security, FireMon
Rich é SVP of Cloud Security na FireMon, onde se dedica à investigação e implementação de segurança na cloud de vanguarda. Rich juntou-se à FireMon através da aquisição da DisruptOps, uma plataforma de automatização de segurança na cloud baseada na sua investigação enquanto CEO da Securosis. Tem mais de 25 anos de experiência em segurança e especializa-se atualmente em segurança na cloud e DevSecOps, tendo começado a trabalhar diretamente com a cloud há quase 10 anos. Antes de fundar a Securosis e a DisruptOps, Rich foi Research Vice President na equipa de segurança da Gartner.