Comprendete il rischio delle policy. Ponete domande sulle policy in linguaggio naturale. Richiedi una demo →
Published:
Il misterioso caso dell'esposizione effimera dei dati
by FireMon
Pur non monitorando attivamente gli account dei clienti alla ricerca di rilevamenti e avvisi, di recente un cliente ci ha contattati chiedendoci un ruolo più proattivo nel suo percorso verso la remediation automatizzata. Su richiesta del cliente, stavamo tenendo d'occhio alcuni aspetti quando... è successo qualcosa di interessante.
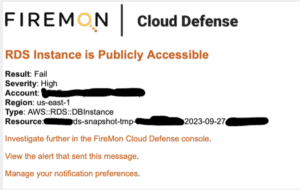
Il nostro CTO ha ricevuto un avviso che segnalava la presenza di un'istanza RDS pubblica esposta in AWS. Tuttavia, quando ha verificato con il cliente, non c'era più. A rendere il tutto ancora più strano, ogni notte veniva creata un'istanza RDS pubblica, per poi essere terminata 50 minuti dopo. Un'attività di questo tipo può facilmente sfuggire durante le valutazioni pianificate. Il nostro CTO ha informato tempestivamente il cliente e ha recuperato dal nostro inventario i metadati dell'istanza terminata. Dopo un'indagine approfondita (e rapida, sono bastati pochi minuti) sugli eventi scatenanti e sulla configurazione dell'istanza, ha scoperto che ogni notte veniva creata un'istanza pubblica a partire dall'ultimo backup snapshot di un altro database. L'istanza veniva poi esposta a un breve elenco di indirizzi IP aziendali noti (il che era una buona notizia) prima di essere terminata poco dopo.
L'indagine
Il cliente ha condotto la propria indagine e ha rilevato che si trattava di parte di un processo di automazione per l'ETL eseguito nel data center. Un job pianificato sul lato cloud era responsabile della creazione dell'istanza effimera come pubblica, limitando l'accesso a una manciata di indirizzi IP (5, che sembravano comunque molti), dopodiché il data center si connetteva per estrarre i dati. Non abbiamo mai scoperto dove avvenisse l'effettiva trasformazione dei dati, ma questo non è particolarmente rilevante ai fini della situazione.
Questo ha rappresentato una sfida interessante per il team di sicurezza: l'avviso era valido, ma non esisteva un problema di sicurezza reale (anche se esistono certamente modi più sicuri di gestire questa situazione rispetto a un'istanza RDS pubblica). Escludere l'istanza non era un'opzione, dato che ogni notte ne veniva creata una nuova. Anche escludere l'intero account dal controllo sarebbe stato rischioso, perché avrebbe potuto portare a non rilevare un'istanza RDS realmente esposta. Persino l'esclusione basata sui tag comportava un rischio, poiché chiunque avrebbe potuto modificare facilmente il processo per esporre l'istanza a un indirizzo IP non attendibile.
Lezioni apprese
Il mio consiglio è stato di concentrarsi sulla correzione del processo sottostante anziché complicare il lato della valutazione. La realtà è che questo processo non è ideale dal punto di vista procedurale: consentire istanze RDS pubbliche non è mai una buona pratica. A volte sono necessarie, ma dovrebbero rappresentare solo l'ultima risorsa. Dovrebbero invece essere collocate in una subnet privata e raggiunte tramite una connessione dedicata o basata su VPN dal punto in cui serve.
Anche se non si è rivelata un'esposizione di sicurezza, ci sono comunque alcune lezioni interessanti da trarre. In primo luogo, definisco questo caso un "falso falso positivo", poiché l'avviso riguardava una condizione reale che richiedeva attenzione, ma che non comportava necessariamente un rischio in questo specifico scenario. Non c'è stata alcuna fuga di dati effettiva, ma il cliente non poteva saperlo senza un'indagine e senza comunicare con il team responsabile della risorsa e del processo.
In secondo luogo, questo è un caso difficile da prevenire completamente con le Service Control Policies. Non esiste una condition key per impedire le istanze RDS pubbliche, né esistono condition key per impedire l'apertura delle porte di database (o di qualsiasi porta) nei security group.
In terzo luogo, la natura effimera delle istanze comporta che, a meno di operare in tempo reale o con cicli molto brevi, l'esposizione potrebbe sfuggire. Affronto questo tema anche nella mia formazione sull'incident response, perché vi sono molte situazioni in cui qualcosa può essere esposto ed estratto in una finestra temporale ristretta, per poi essere distrutto in seguito così da eliminare le prove. Per questo motivo gli incident responder devono sempre avere la capacità di intervenire direttamente nei deployment e devono poter accedere a un inventario che consenta di guardare indietro nel tempo (come AWS Config o uno strumento di terze parti come il nostro). Le sole chiamate API potrebbero non fornire una visibilità sufficiente su ciò che sta accadendo, perché prive di contesto. In questo caso si rileverebbe l'esposizione, ma occorrerebbe poi esaminare direttamente l'istanza DB (o l'inventario) per vedere quali porte sono esposte e verso dove.
In quarto luogo, date le limitate opzioni preventive disponibili, occorre ricorrere a controlli investigativi e correttivi. In questo caso è possibile rilevare direttamente la chiamata API CreateDBInstance e verificare il parametro PubliclyAccessible=True. Inoltre, è vivamente consigliato il monitoraggio continuo con CSPM (ancora una volta, del vostro CSP o di un fornitore come noi) per le istanze RDS pubbliche. In termini di remediation, un'opzione è terminare l'istanza al rilevamento della sua creazione. Tuttavia, un approccio migliore può essere utilizzare ModifyDBInstance per rimuovere il parametro PubliclyAccessible. In tal caso, è importante implementare questa automazione solo in un deployment in cui si abbia la certezza che le istanze RDS pubbliche non saranno consentite. Il giorno in cui interromperete una connessione di database prevista e autorizzata, attiva da 3 anni, perché non avete comunicato con il team, sarà probabilmente un buon giorno per tirare fuori il curriculum.
In definitiva, questo episodio non ha comportato un rischio di sicurezza per il cliente. Ha però evidenziato la necessità di processi più sicuri, e il cliente sta attivamente valutando opzioni per gestire la situazione in modo più sicuro. Trovo questo esempio particolarmente interessante perché le esposizioni, le fughe e le esfiltrazioni effimere di dati sono preoccupazioni reali, e ciò che abbiamo inizialmente rilevato appariva indistinguibile da un attacco vero e proprio. Solo dopo un'analisi approfondita noi e il team di sicurezza del cliente abbiamo capito che faceva parte di un processo previsto. È fondamentale collaborare strettamente con i propri team per coltivare buone abitudini, assicurarsi che il monitoraggio sia in grado di gestire la natura estremamente volatile del cloud e comprendere che, quando si verifica qualcosa di insolito come in questo caso, è essenziale coinvolgere le persone responsabili del deployment.
Nel cloud, a volte l'unico modo per distinguere tra un falso positivo e un problema davvero grave è verificare con chi è direttamente coinvolto. Come ho scritto in Schrödinger’s Misconfigurations, gli aggressori utilizzano le stesse chiamate API e, purtroppo, le stesse identità, anziché fare affidamento su qualche vulnerabilità zero-day.
Relatore ospite
Rich Mogull
SVP of Cloud Security, FireMon
Rich è SVP of Cloud Security presso FireMon, dove si occupa di ricerca e implementazione all'avanguardia nella sicurezza cloud. Rich è entrato in FireMon con l'acquisizione di DisruptOps, una piattaforma di automazione della sicurezza cloud nata dalle sue ricerche durante il periodo come CEO di Securosis. Ha oltre 25 anni di esperienza nella sicurezza e attualmente è specializzato in sicurezza cloud e DevSecOps, avendo iniziato a lavorare operativamente sul cloud quasi 10 anni fa. Prima di fondare Securosis e DisruptOps, Rich è stato Research Vice President nel team sicurezza di Gartner.