Comprenez le risque lié aux politiques. Posez vos questions sur les politiques en langage courant. Demander une démo →
Published:
Contenir des identifiants EC2 compromis sans (espérons-le) tout casser
by FireMon
Il existe plusieurs techniques pour contenir des identifiants d'instance compromis. Les plus simples sont aussi les plus susceptibles de casser quelque chose, mais il existe des options créatives permettant d'exclure les attaquants sans interrompre les applications.
Ces dernières années, Amazon a réalisé des avancées majeures pour réduire les risques qu'un attaquant vole et détourne les identifiants attribués aux instances AWS. D'accord, une grande partie de ces progrès est intervenue après cette très grande violation dont tout le monde parle encore, mais nous disposons désormais de bien meilleurs outils pour prévenir ce type d'attaque. Cela dit, elle reste très courante et figure en bonne place sur toutes les listes de menaces cloud.
Le mois dernier, AWS a publié de nouvelles options de politique pour verrouiller les identifiants d'instance, ce qui a inspiré cet article. Cela, et une découverte intéressante issue de la communauté de la sécurité cloud dont je parlerai dans un instant. Aussi utile que soit cette nouvelle capacité, combinée à l'amélioration spectaculaire par AWS de ses détections GuardDuty pour l'exfiltration d'identifiants, il se peut qu'à un moment donné vous receviez une alerte d'un outil comme le nôtre et deviez enclencher votre processus de réponse aux incidents :
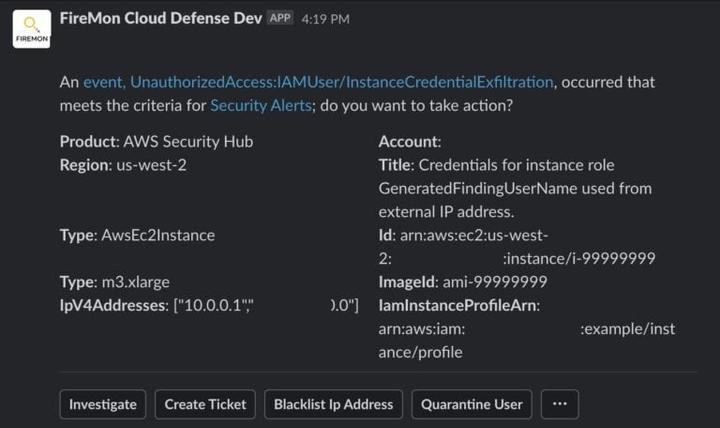
Au fil des années, j'ai compilé et testé toute une série d'options de confinement, dont la plupart font l'objet de laboratoires dans la formation à la réponse aux incidents cloud que j'ai conçue avec Will Bengtson. Il existe une quantité surprenante de subtilités à maîtriser pour parvenir à contenir l'attaquant sans rien casser. Lorsque vous travaillez avec des identifiants d'instance, vous interagissez en réalité avec trois composants : le service IAM qui gère les autorisations, l'Instance Metadata Service (IMDS) qui se charge de transmettre ces identifiants à l'instance, et le code/SDK exécutant votre application au sein de l'instance et utilisant les identifiants. Notez que je simplifie délibérément certains points et que je laisse de côté les Service Control Policies et les politiques de ressources (buckets). (Toutes les captures d'écran de cet article sont effrontément tirées de ma propre formation, merci donc de ne pas me dénoncer aux autorités.)
Et un bref rappel pour ceux qui l'ignorent : lorsque vous attribuez un rôle IAM à une instance, celle-ci reçoit des identifiants à rotation automatique qui lui confèrent les autorisations de ce rôle. Mais si un attaquant parvient à accéder à l'instance d'une manière ou d'une autre, par exemple via une attaque SSRF ou une attaque par force brute sur SSH, il peut copier ces identifiants et les utiliser en dehors d'AWS ou depuis un compte AWS qu'il contrôle.
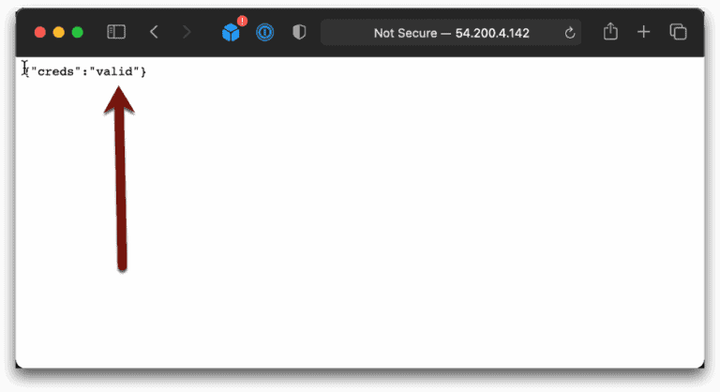
Pour la mise en place, Will a écrit une petite application qui tente d'établir une connexion interne vers un bucket S3 et indique si les identifiants sont valides (non, les adresses IP affichées ne sont plus valides) :
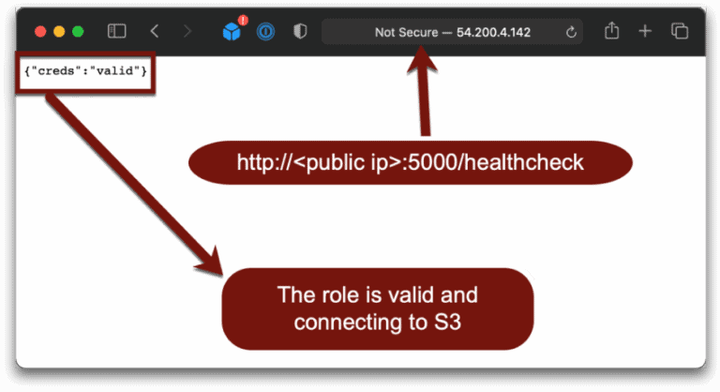
Option 1 : ajouter une politique Deny All au rôle
C'est de loin la méthode la plus simple et la plus rapide. En ajoutant une politique Deny All au rôle IAM, tous les appels d'API échoueront et l'attaquant ne pourra plus causer de dommages.
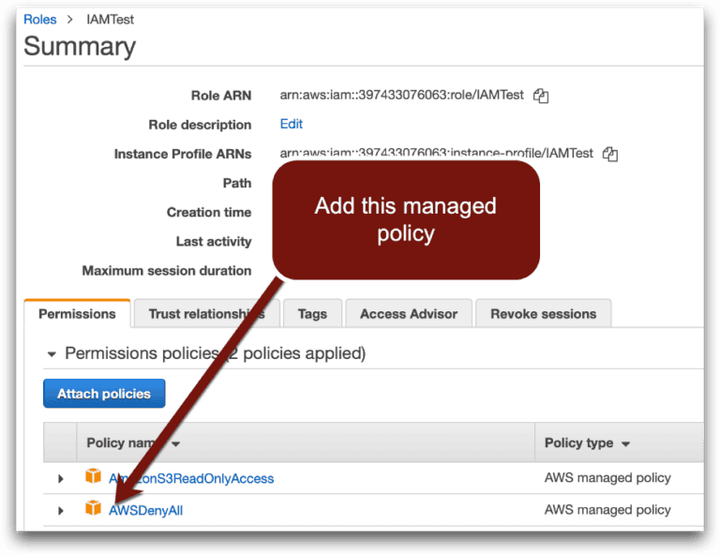
C'est rapide, c'est facile, et c'est aussi un très bon moyen de casser votre application, puisque cela bloquera également tous les appels d'API légitimes :
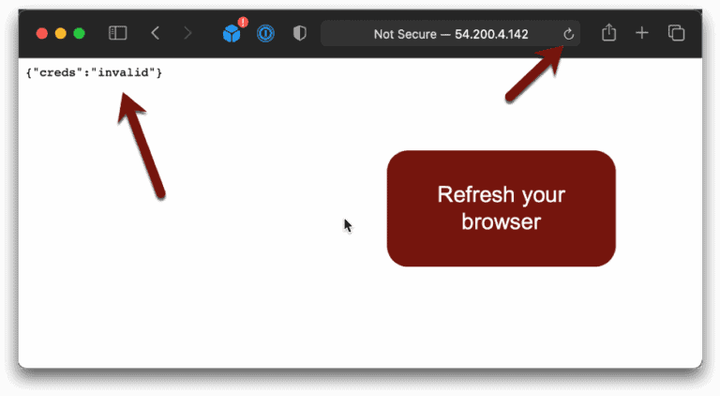
Rappelez-vous, notre objectif est de tenir l'attaquant à l'écart sans interrompre nos applications légitimes en cours d'exécution.
Raté.
Option 2 : révoquer la session
AWS propose une fonctionnalité intéressante pour révoquer les sessions actives. D'un simple clic dans la console, vous pouvez ajouter une politique Deny All personnalisée qui refuse l'accès uniquement aux sessions démarrées avant l'heure définie au moment du clic (il n'existe pas d'appel d'API simple pour cela, mais il n'est pas difficile d'écrire votre propre politique pour obtenir le même résultat).
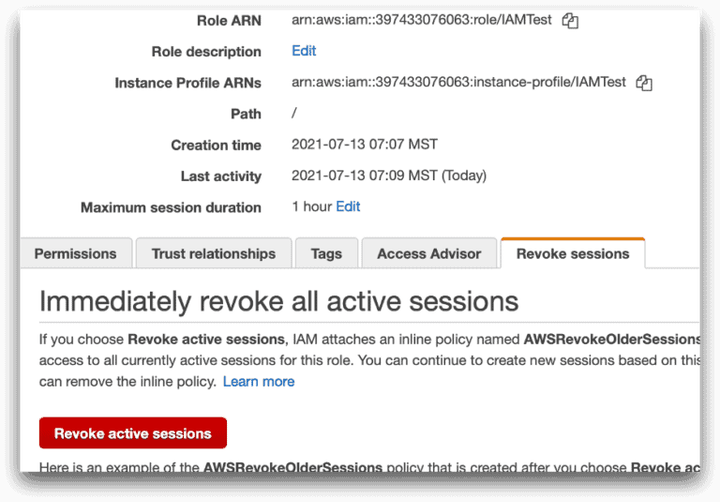
En supposant que vous ayez empêché l'attaquant de compromettre la nouvelle session, cela devrait en théorie l'exclure en faisant expirer les identifiants volés tout en permettant à votre application de fonctionner avec les nouveaux. Mais…
Eh bien non. Deuxième raté. Pourquoi ?
L'IMDS ne met à jour les identifiants qu'à leur expiration. L'IMDS est un service distinct d'IAM : il ne sait pas que vous avez révoqué des identifiants et n'a aucune raison, ni aucune motivation, d'aller chercher les nouveaux identifiants pour les fournir à l'instance. Il continuera à servir les identifiants révoqués jusqu'à la fin de la session.
Option 3 : changer le rôle IAM et refuser l'ancien rôle
Les choses commencent à devenir subtiles. Et si nous créions un nouveau rôle, que nous faisions basculer l'instance sur ce nouveau rôle et que nous bloquions l'ancien ? Comme précédemment, cela ne fonctionnerait que si vous êtes certain que l'attaquant ne peut pas simplement voler les identifiants du nouveau rôle.
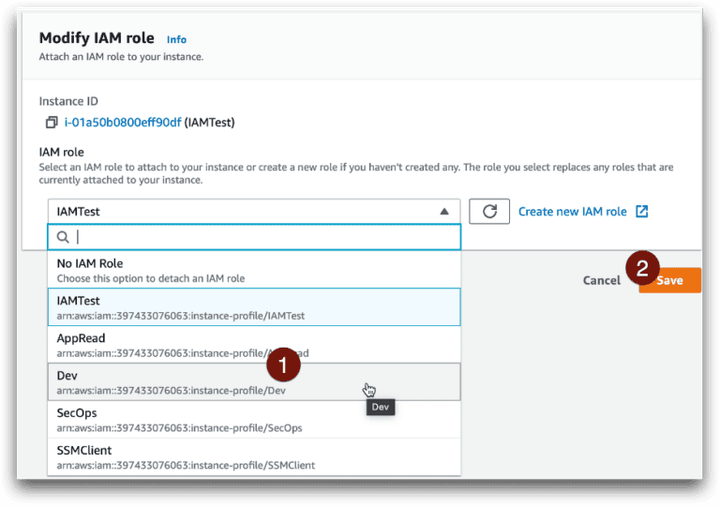
Eh bien non. Troisième raté. Que se passe-t-il donc ?
La plupart des codes et SDK établissent une session IAM à leur démarrage et récupèrent les identifiants auprès du service de métadonnées. Ces identifiants ont une durée de session, comparable à une durée de vie (TTL). Ils sont conservés en mémoire et utilisés jusqu'à l'approche de la fin de cette durée. Par exemple, avec la bibliothèque Boto en Python (celle que nous avons utilisée pour cette démonstration), le code ne recherchera de nouveaux identifiants que 15 minutes avant leur expiration.
L'application continuera donc d'échouer jusqu'à ce qu'elle recherche des identifiants mis à jour. Selon la configuration, cela se produit généralement toutes les 6 heures par défaut dans une instance EC2. Bon, peut-être avez-vous d'excellents développeurs dotés d'une gestion des erreurs irréprochable, qui tenteront de récupérer de nouveaux identifiants après l'échec d'un appel d'API, mais c'est peu probable, car ce n'est pas un cas d'usage courant.
Le code de l'instance continue d'essayer d'utiliser l'ancien rôle parce qu'il n'en sait pas plus. Dans l'option 2, nous avons cassé les choses parce que l'IMDS ne savait pas qu'il devait interroger IAM pour mettre à jour les identifiants. Cette fois, c'est le code qui ne sait pas qu'il doit interroger l'IMDS pour obtenir de nouveaux identifiants.
Option 4 : insérer un VPC endpoint
Celle-ci, c'est moi qui ai voulu faire dans la subtilité : c'est de loin la plus complexe, mais elle fonctionne très bien. Toutes les instances résident dans un VPC (Virtual Private Cloud), qui constitue leur réseau virtuel dans AWS. Normalement, tous les appels d'API passent par Internet pour atteindre les endpoints publics d'AWS. De fait, si vous avez une instance dans un sous-réseau privé sans route sortante vers Internet, ces appels d'API échoueront.
C'est un problème de taille si vous voulez que votre instance privée communique avec votre propre bucket S3 privé. Auparavant, il fallait activer l'accès à Internet, ce qui engendre des coûts et ouvre les choses d'une manière que nous, professionnels de la sécurité, cherchons à réduire au minimum.
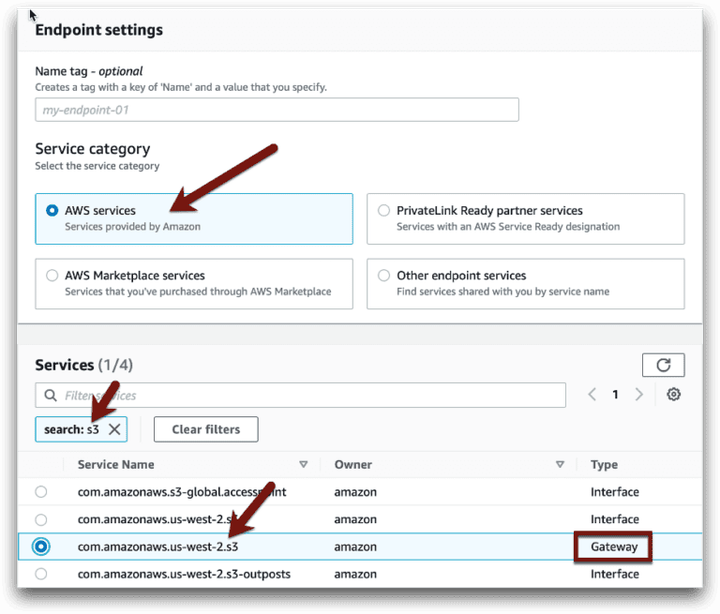
La réponse d'Amazon s'appelle le Service Endpoint. Il s'agit de structures de routage internes, définies par logiciel, que vous pouvez configurer pour permettre aux ressources d'un VPC de communiquer avec des endpoints d'API (et d'autres éléments, mais ce n'est pas l'objet de cet article) entièrement au sein du réseau interne d'Amazon. Le plus intéressant, c'est que lorsque vous utilisez un VPC endpoint, AWS insère un contexte supplémentaire dans le trafic réseau, puisqu'il peut désormais intégrer des données dans ses en-têtes privés, et nous pouvons nous en servir comme conditions dans nos politiques IAM !
Nous ajoutons d'abord un VPC endpoint pour S3 dans le sous-réseau où se trouve notre instance :
Nous ajoutons ensuite à notre politique IAM une condition qui refuse tout trafic ne provenant pas du VPC attendu. Voici comment nous procédons dans le laboratoire de formation :
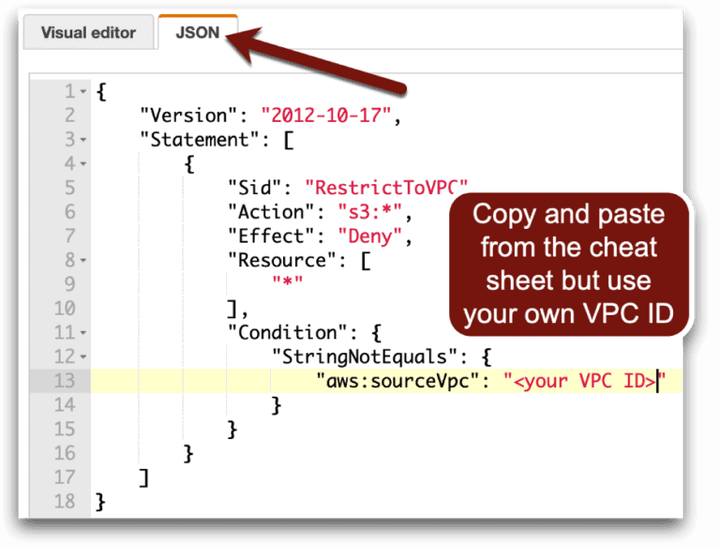
Si cela fonctionne, les appels d'API depuis notre instance continueront de fonctionner, mais les identifiants échoueront s'ils sont utilisés depuis un autre emplacement que ce VPC (espérons donc que l'attaquant n'a pas accès à une autre ressource du VPC).
Excellent ! Nos identifiants ne fonctionneront que depuis l'intérieur du VPC et l'attaquant est exclu. C'est EXACTEMENT ainsi que fonctionne la Service Control Policy que j'ai mentionnée plus haut. Le problème avec la SCP, c'est que les service endpoints ajoutent des coûts et de la complexité, et qu'activer cette politique sans disposer de tous les endpoints nécessaires cassera des choses, mais cette fois à l'échelle de l'entreprise.
Un comportement inattendu
Comme je l'ai indiqué, nous avons construit ce laboratoire il y a environ 2 ans et y avons fait passer quelques centaines de participants. La semaine dernière, Andre Rall, de Uptycs , a publié le message suivant dans une communauté de sécurité cloud à laquelle nous participons tous les deux (reproduit avec autorisation) :
Quelqu'un sait-il si ce comportement est normal ? J'ai un rôle rattaché à un instance profile associé à une instance. Lorsque je retire le rôle de l'instance profile (via la CLI) tout en conservant l'instance profile associé à l'instance, l'instance reste capable d'utiliser les identifiants du rôle. Mon intuition me dit que, le rôle n'étant plus rattaché, l'instance ne devrait pas pouvoir continuer à l'utiliser, mais peut-être que quelque chose m'échappe.
Il s'avère que nous retrouvons ici cette interaction entre services. En coulisses, l'instance profile est ce qu'AWS utilise pour lier un rôle à une instance dans le service de métadonnées. Andre a retiré le rôle de l'instance profile, mais le rôle existe toujours et l'instance profile aussi.
On pourrait penser que l'IMDS ne serait plus en mesure de servir les identifiants, mais il les DÉTIENT toujours et ignore ce qui s'est passé du côté du service IAM. Il continue donc de les servir, et le rôle continue de les autoriser : ils fonctionnent toujours. Révoquer les identifiants FONCTIONNERAIT dans ce cas, car l'IMDS ne pourrait pas obtenir les nouveaux identifiants une fois l'instance profile et le rôle dissociés.
Le confinement des identifiants IAM comporte de nombreuses subtilités, et il ne s'agit ici que d'une série d'exemples portant sur un seul service (EC2). Mais une fois que vous aurez compris le flux entre le service IAM, l'IMDS et les SDK, vous disposerez d'une base solide sur certains des principes fondamentaux applicables à d'autres situations.
Et n'oubliez pas de découvrir l'offre gratuite FireMon Cloud Defense que nous venons de lancer.