Comprenez le risque lié aux politiques. Posez vos questions sur les politiques en langage courant. Demander une démo →
Published:
Les 2 meilleurs conseils d'un paramédic pour la réponse aux incidents dans le cloud
by Rich Mogull
L'un des avantages d'avoir de nombreux loisirs singuliers, c'est qu'ils câblent le cerveau un peu différemment. On se surprend à aborder les problèmes sous un autre angle, à mesure que l'on contamine mentalement un domaine par un autre. En tant que paramédic semi-actif, je trouve une multitude de parallèles entre la prise en charge des urgences de chair et d'os et la gestion des urgences de bits et d'octets.
J'enseigne beaucoup la réponse aux incidents dans le cloud depuis quelques années et j'ai commencé à utiliser deux expressions issues du monde paramédical qui trouvent un bon écho auprès des intervenants en devenir. Ces aide-mémoire permettent de mieux cibler l'attention et d'optimiser le processus. Bien qu'ils s'appliquent à toute réponse à incident, je constate qu'ils jouent un rôle plus important côté cloud, en raison des différences inhérentes causées avant tout par l'existence du plan de gestion.
Malade ou pas malade
Les paramédics peuvent faire beaucoup par rapport à une personne lambda, mais nous restons assez limités dans le domaine de la médecine. Nous sommes remarquablement entraînés à reconnaître rapidement les menaces vitales ou fonctionnelles, qu'elles soient médicales ou traumatiques, puis à stabiliser et transporter les patients vers des soins définitifs. Une expression clé que l'on nous martèle est « malade ou pas malade ». C'est un aide-mémoire qui nous rappelle de nous concentrer sur la vue d'ensemble et de déterminer si le patient est en grande difficulté.
J'adore m'en servir pour aider les professionnels de la sécurité de l'information à évaluer la gravité d'un incident. Pour le cloud, nous leur apprenons à repérer les constats significatifs qui exigent de se concentrer sur un problème immédiatement, avant de poursuivre. Dans les services d'urgence, on parle de « menace vitale ». Comme la réponse aux incidents dans le cloud s'appuie sur des compétences existantes appliquées à une nouvelle technologie sous-jacente, cette expression n'est qu'un rappel : il faut considérer les conséquences d'un constat qui ne déclencherait pas normalement l'instinct d'un intervenant. Voici quelques exemples simples :
- Des données rendues publiques dans un stockage objet (S3) alors qu'elles ne devraient pas l'être.
- Une entité IAM potentiellement compromise disposant de privilèges d'administration ou d'autres privilèges élevés.
- Plusieurs appels d'API réussis utilisant différents utilisateurs IAM depuis une même adresse IP inconnue.
- Le partage inter-comptes d'une image ou d'un instantané avec un compte inconnu.
- Une instance/VM potentiellement compromise disposant de privilèges IAM.
Quand je les énonce ainsi, la plupart des intervenants répondent « évidemment, c'est une évidence », mais d'après mon expérience, les intervenants traditionnels ont besoin d'un peu de temps pour reconnaître ces problèmes et comprendre qu'ils sont bien plus critiques qu'une machine virtuelle compromise ordinaire.
« Malade ou pas malade » dans le cloud se traduit presque toujours par « est-ce public ou l'attaquant est-il passé dans le plan de gestion (IAM) ».
Malade ou pas malade. Chaque fois que vous trouvez un nouvel élément de preuve, une nouvelle pièce du puzzle, passez-la par ce filtre mental pour déterminer si votre patient est sur le point de s'effondrer ou s'il a simplement le nez qui coule.
Arrêter l'hémorragie
Beaucoup d'entre vous ont probablement suivi une formation en réanimation cardio-pulmonaire et en premiers secours. Vous y avez sans doute appris les « ABC » : Airway (voies aériennes), Breathing (respiration) et Circulation.
Eh bien, il s'avère que nous nous sommes vraiment trompés sur ce point.
Les recherches ont commencé à montrer qu'en situation d'urgence, les gens se concentraient sur les ABC au détriment de la vue d'ensemble. Même des paramédics se retrouvaient à pratiquer une réanimation cardio-pulmonaire sur une personne en train de se vider de son sang à cause d'une plaie à la jambe. Parfois, la réanimation était parfaite. On le voyait à la vitesse à laquelle le patient se vidait de son sang. Aujourd'hui, nous ajoutons « traiter la menace vitale » au début, et « arrêter l'hémorragie » est la priorité absolue.
Vous voyez où je veux en venir ?
Dans chacun des cours que j'ai donnés, je constate que des intervenants très expérimentés se concentrent sur leur analyse et leur investigation pendant que le cloud se vide de son sang sous leurs yeux. Pourquoi ?
Parce qu'ils n'ont pas l'habitude que tout soit (potentiellement) sur Internet. L'ensemble du plan de gestion est sur Internet : si un attaquant obtient des identifiants, vous ne pouvez pas l'arrêter avec un pare-feu ni en coupant l'accès à un serveur. Si quelque chose est compromis et exposé, c'est compromis et exposé à… eh bien, potentiellement tout le monde, partout, en même temps.
Arrêter l'hémorragie va de pair avec malade ou pas malade. Si vous trouvez quelque chose de malade, devez-vous le contenir immédiatement avant de poursuivre ? C'est un équilibre délicat, car si vous vous trompez, vous risquez de perdre un temps précieux pendant que l'attaquant progresse. Arrêter l'hémorragie signifie « c'est si grave que je dois corriger cela maintenant ». Mais une fois l'hémorragie arrêtée, vous devez revenir exactement là où vous en étiez et poursuivre votre analyse et votre processus de réponse, car de nombreux éléments malveillants peuvent encore être à l'œuvre.
Ma liste courte ?
- Toute entité IAM à privilèges élevés qui semble compromise.
- Des données sensibles rendues publiques d'une manière ou d'une autre.
- Un partage ou un accès inter-comptes/abonnements/projets vers une destination inconnue.
Il y en a d'autres, mais voilà la liste courte. Chacun de ces éléments indique une perte de données ou une compromission active : vous devez les contenir immédiatement.
Mise en pratique
Voici un exemple. Les captures d'écran mêlent Slack, la console AWS et FireMon Cloud Defense. C'est ma chaîne d'outils, et cela fonctionnera avec ce dont vous disposez. Dans les formations, nous utilisons aussi des requêtes Athena pour simuler un SIEM, mais je souhaite garder cet article (relativement) court.
Commençons par une alerte de gravité moyenne dans Slack, émise par notre plateforme combinée CSPM/CDR :
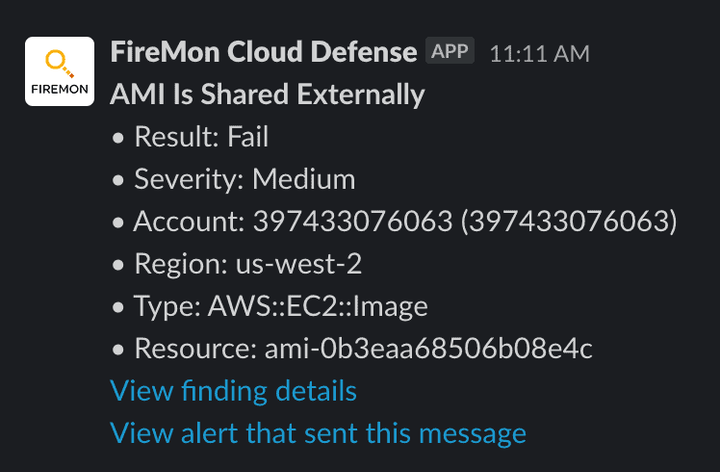
Malade ou pas malade ? Nous ne le savons pas encore. Cela pourrait être tout à fait légitime. Bien, il est temps d'enquêter. Je vais le montrer à la fois dans la plateforme et dans la console AWS. Ma première étape consiste à voir ce qui est partagé et où. Comme l'alerte contient l'ID de l'AMI, nous pouvons y accéder directement :
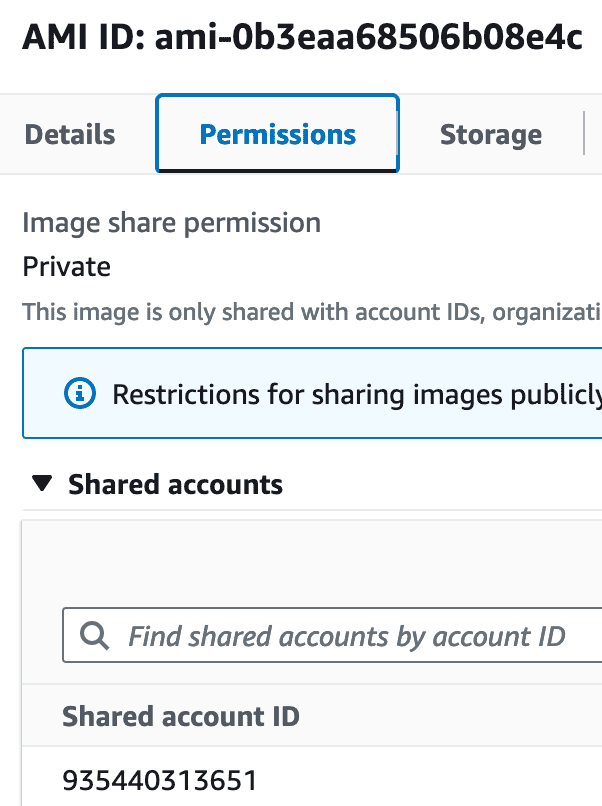
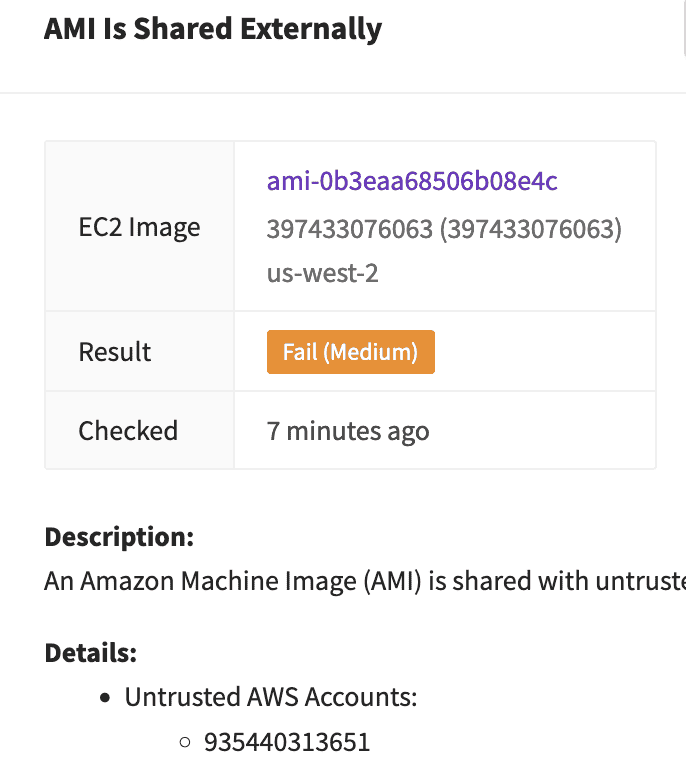
Bien : je vois que l'image est partagée avec un autre compte. Est-ce un compte qui m'appartient ? Que je connais ? Mon outil le signale comme non approuvé puisqu'il ne s'agit pas d'un compte enregistré dans le système, mais dans la réalité, je voudrais consulter la liste principale des comptes de mon organisation pour vérifier.
Bien, malade ou pas malade ? Dans ma tête, c'est encore un peut-être. J'ai une image partagée avec un compte potentiellement non approuvé. Mais je ne sais pas encore ce qui est partagé. Je dois remonter à l'instance source. Je ne m'embarrasse pas d'une analyse forensique complète ; je vais m'appuyer sur les informations contextuelles, car je dois trancher assez vite. Dans ce cas, nous avons eu de la chance :
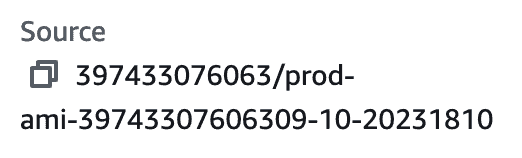
Le nom contient « Prod », donc… je qualifie cela de « probablement malade ». Arrêter l'hémorragie ? Dans la réalité, j'essaierais d'abord de contacter le propriétaire de ce compte AWS, mais pour aujourd'hui, j'estime disposer de suffisamment d'informations pour mettre l'AMI en quarantaine. Voici comment procéder dans la console et dans Cloud Defense :
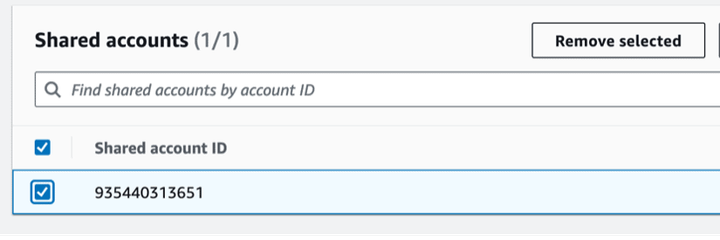
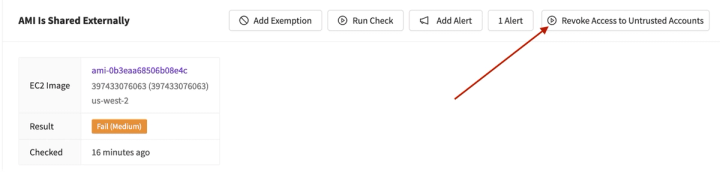
Bien, avons-nous arrêté l'hémorragie ? Nous avons arrêté… une partie de l'hémorragie. Nous avons verrouillé l'AMI, mais nous ne savons toujours pas comment elle a fini là. Nous ne savons pas non plus à qui appartient ce compte AWS. Pouvons-nous le découvrir ? Non. S'il ne nous appartient pas, tout ce que nous pouvons faire est de le signaler à AWS et de les laisser gérer la suite.
Partons à la recherche des appels d'API pour découvrir qui a partagé l'image et ce qu'il a fait d'autre. Je vais effectuer les étapes suivantes dans la plateforme, mais vous exécuteriez des requêtes dans votre SIEM ou dans Athena pour obtenir les mêmes informations. Je consacrerai de futurs articles à toutes ces requêtes, mais celui-ci porte sur les notions de malade/hémorragie.
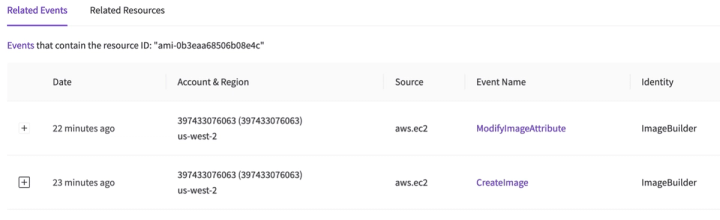
Bien : je vois qu'une entité IAM nommée ImageBuilder est à l'origine de l'action. Là encore, comme cet article est déjà long, j'ai vérifié quelques éléments et voici ce que j'ai appris :
- ImageBuilder est un utilisateur IAM autorisé à créer des images et à modifier leurs attributs, mais rien de plus. Toutefois, la politique ne comporte aucune restriction de ressource : elle peut donc créer une image de n'importe quelle instance. Et aucune restriction conditionnelle : elle peut donc partager avec n'importe quel compte. Le rayon d'impact est modéré à faible : il y a sur-privilège, mais pas de façon dramatique. J'appelle cela plutôt malade.
- L'appel d'API provenait d'une adresse IP inconnue. C'est suspect, mais cela reste seulement plutôt malade.
- C'est la première fois que je vois cette adresse IP utilisée par cet utilisateur IAM, et l'utilisateur présente une activité antérieure correspondant à un traitement par lots. Bien, je penche désormais vers malade. En général, on n'observe pas d'adresses IP changeantes pour ce type de tâches ; cela sent l'identifiant perdu :
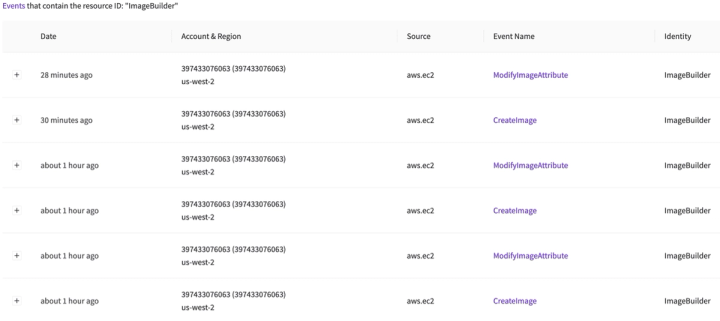
- Cet utilisateur IAM peut continuer à effectuer ces actions. À moins que quelqu'un ne me dise que c'était intentionnel, je qualifie cela de Malade et je vais Arrêter l'hémorragie et appliquer une restriction IAM à ce compte utilisateur (probablement une politique Deny All, sauf s'il s'agit d'un processus critique, auquel cas j'utiliserais une restriction par IP).
En résumé :
- J'ai trouvé une AMI partagée avec un compte inconnu : Malade
- Cette AMI concernait un actif de production : Malade et arrêter l'hémorragie
- L'action provenait d'un utilisateur IAM disposant de larges privilèges pour créer des AMI et les partager, mais rien d'autre : Peut-être malade, investigation en cours.
- L'utilisateur IAM a créé cette AMI depuis une adresse IP inconnue et nouvelle : Malade, arrêter le reste de l'hémorragie.
- Aucune autre activité n'a été détectée en provenance de cette adresse IP : probablement circonscrit et plus « Sick »
- Je ne sais toujours pas comment ces identifiants ont fuité : « Sick », et il est temps de faire appel à nos collègues de la réponse à incident traditionnelle pour déterminer s'il s'agit d'une compromission du réseau ou d'un hôte.
J'ai parcouru cet exemple rapidement afin de montrer comment j'aborde ce type de problème. À quelques différences près, ce même signalement aurait été tout à fait normal. Imaginez que nous nous rendions compte que le partage visait un nouveau compte qui nous appartient mais qui n'était pas encore enregistré. Ou que l'AMI concernait une instance de développement ne contenant rien de sensible. Ou encore que les appels d'API provenaient de notre réseau, à l'heure attendue, ou du système d'un administrateur qui avait bien l'intention de la partager. Cet exemple n'a rien d'extrême, mais il constitue une forme connue d'exfiltration de données employée par des acteurs malveillants actifs. À mesure que je recueille chaque information, j'évalue s'il s'agit d'un cas « Sick » ou « Not Sick » et si je dois « Stop the Bleed ».
En quoi est-ce différent dans le cloud ? Parce que les enjeux sont plus élevés lorsque tout est potentiellement exposé à Internet. Nous devons réfléchir et agir plus vite, et je trouve ce moyen mnémotechnique utile pour garder le cap.