Comprenda el riesgo de sus políticas. Haga preguntas sobre políticas en lenguaje natural. Solicitar un demo →
Published:
Contención de credenciales EC2 comprometidas sin (ojalá) romper nada
by FireMon
Existen múltiples técnicas para contener credenciales de instancia comprometidas. Las más fáciles son las que tienen más probabilidades de romper algo, pero hay opciones creativas para bloquear a los atacantes sin romper las aplicaciones.
En los últimos años hemos visto avances importantes de Amazon para ayudar a reducir los riesgos de que un atacante robe y abuse de las credenciales asignadas a las instancias de AWS. Está bien, sí, mucho de esto ocurrió después de aquella brecha de seguridad realmente grande de la que todo el mundo sigue hablando, pero ahora contamos con herramientas mucho mejores para prevenir este tipo de ataque. Dicho esto, sigue siendo muy común y ocupa un lugar alto en la lista de amenazas de cloud de todos.
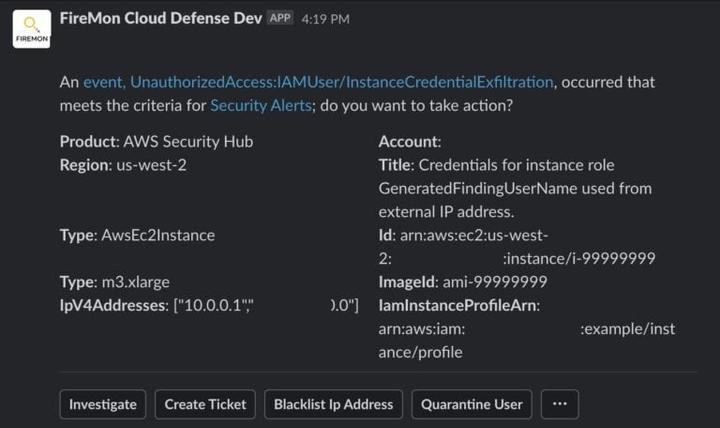
El mes pasado AWS publicó algunas nuevas opciones de políticas para restringir las credenciales de instancia, lo que impulsó la idea de esta publicación. Eso y un hallazgo interesante de la comunidad de seguridad en cloud del que hablaré en un momento. Por más excelente que sea esta nueva capacidad, combinada con la enorme mejora de AWS en sus detecciones de GuardDuty para la exfiltración de credenciales, en algún momento podría recibir una alerta de una herramienta como la nuestra y tener que poner en marcha su proceso de respuesta a incidentes:
A lo largo de los años he recopilado y probado una serie de opciones de contención, para la mayoría de las cuales tengo laboratorios en la capacitación de respuesta a incidentes en cloud que armé con Will Bengtson. Hay una cantidad sorprendente de matices para lograr contener al atacante sin romper nada. Al trabajar con credenciales de instancia, en la práctica se interactúa con tres componentes: el servicio IAM, que maneja los permisos; el Instance Metadata Service (IMDS), que se encarga de pasar esas credenciales a la instancia; y el código/SDK que ejecuta su aplicación dentro de la instancia y que usa las credenciales. Tenga en cuenta que estoy simplificando algunas cosas deliberadamente y que estoy omitiendo las Service Control Policies y las políticas de recursos (buckets). (Todas las capturas de pantalla de esta publicación están descaradamente tomadas de mi propia capacitación, así que por favor no me denuncie ante las autoridades.)
Y un breve contexto para quienes no lo sepan: cuando se asigna un rol de IAM a una instancia, esa instancia recibe credenciales que rotan automáticamente y que le otorgan los permisos de ese rol. Pero si un atacante logra acceder a la instancia de alguna manera, por ejemplo mediante un ataque SSRF o forzando SSH por fuerza bruta, puede copiar esas credenciales y usarlas fuera de AWS o desde una cuenta de AWS bajo su control.
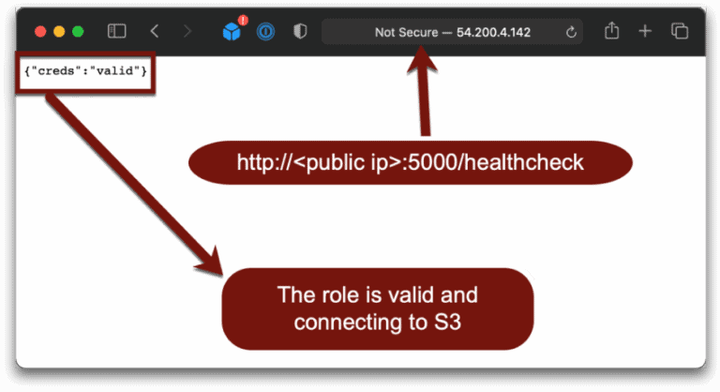
Como preparación, Will escribió una pequeña aplicación que intenta establecer una conexión interna con un bucket de S3 e informa si las credenciales son válidas (no, las direcciones IP que se muestran ya no son válidas):
Opción 1: agregar una política Deny All al rol
Esta es, de lejos, la más fácil y rápida. Al agregar una política Deny All al rol de IAM, todas las llamadas a la API fallarán y el atacante no podrá causar más daño.
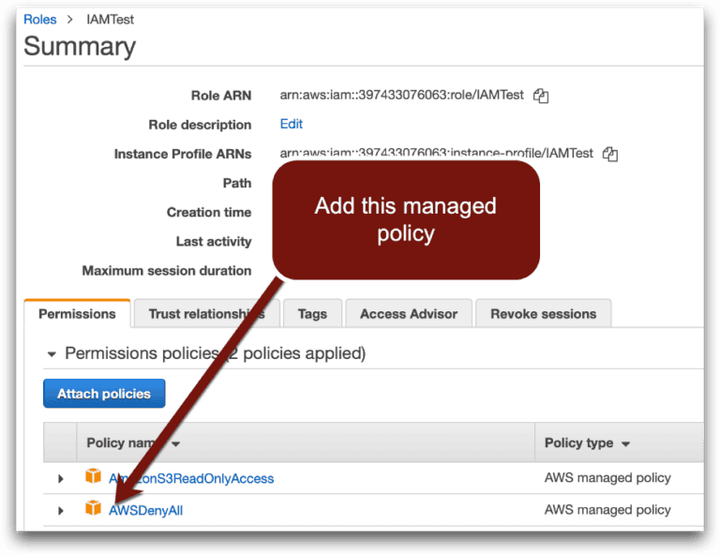
Es rápida, fácil y una forma muy veloz de romper su aplicación, ya que esto detendrá cualquier llamada a la API legítima:
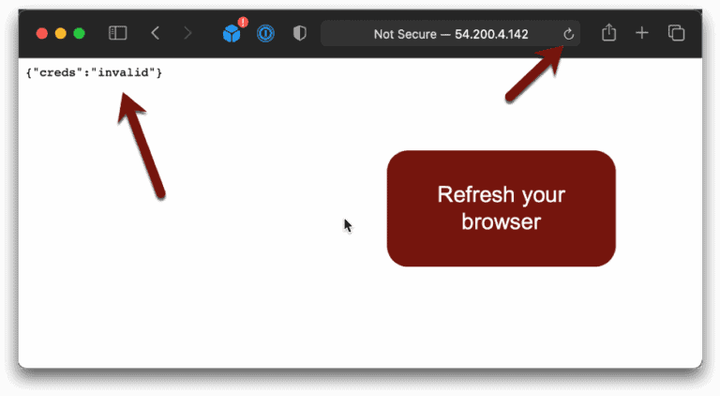
Recuerde: nuestro objetivo es mantener fuera al atacante sin romper nuestras aplicaciones legítimas en ejecución.
Ups.
Opción 2: revocar la sesión
AWS tiene una función interesante para revocar sesiones activas. Con un clic en un botón de la consola puede agregar una política Deny All personalizada que solo deniega el acceso a las sesiones iniciadas antes del momento establecido al hacer clic en el botón (no existe una llamada a la API sencilla para esto, pero no es difícil escribir su propia política para hacer lo mismo).
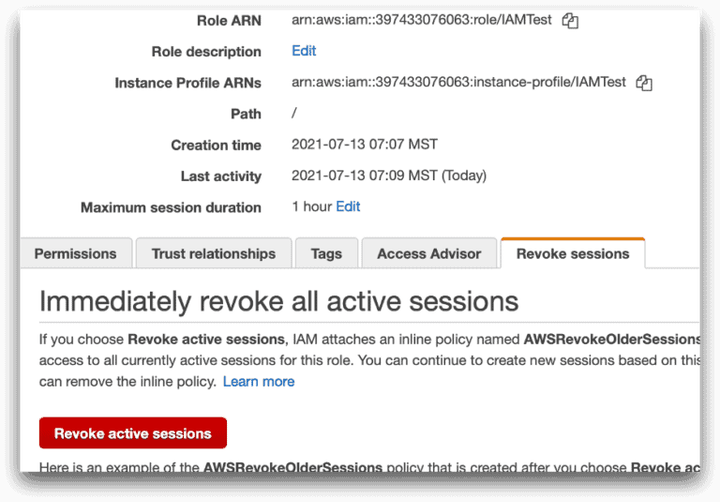
Ahora, suponiendo que impidió que el atacante comprometiera la nueva sesión, en teoría esto lo dejaría fuera al expirar las credenciales robadas y permitiría que su aplicación funcione con unas nuevas. Pero…
No. Ups número 2. ¿Por qué?
El IMDS solo actualizará las credenciales cuando estas expiren. El IMDS es un servicio distinto de IAM y no sabe que usted revocó las credenciales, y no tiene motivo, ni incentivo, para obtener las nuevas credenciales y entregárselas a la instancia. Seguirá sirviendo las credenciales revocadas hasta el final de la sesión.
Opción 3: cambiar el rol de IAM y denegar el rol anterior
Ahora empezamos a ponernos creativos. ¿Y si creamos un rol nuevo, cambiamos la instancia para que use el nuevo y bloqueamos el anterior? Como antes, esto solo funcionaría si sabe que el atacante no puede simplemente robar las credenciales del nuevo rol.
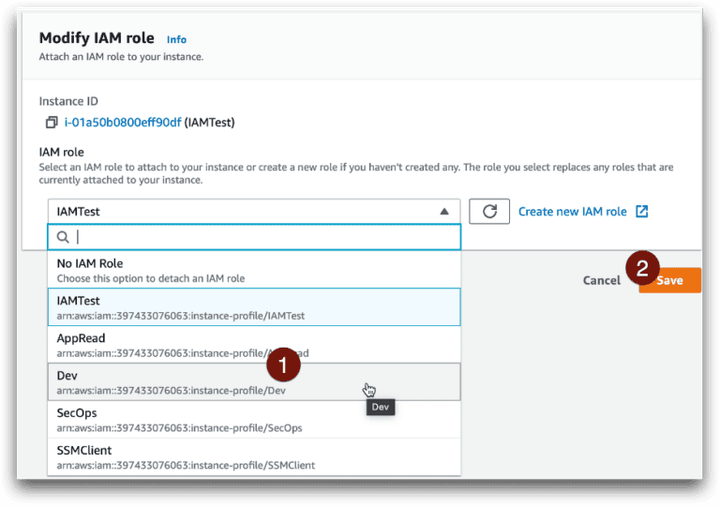
No. Ups número 3. Entonces, ¿qué está pasando aquí?
La mayoría del código y los SDK establecen una sesión de IAM cuando se inician y obtienen las credenciales del servicio de metadatos. Estas credenciales tienen una duración de sesión, que es similar a un tiempo de vida (TTL). Las credenciales se mantienen en memoria y se usan hasta casi el final de la duración. Por ejemplo, al usar la biblioteca Boto en Python (que fue lo que hicimos para este demo), el código no buscará nuevas credenciales hasta 15 minutos antes del vencimiento de las credenciales.
Así, la aplicación seguirá fallando hasta que busque credenciales actualizadas. Según cómo estén configuradas las cosas, esto suele ser cada 6 horas de forma predeterminada en una instancia EC2. Está bien, quizá tenga desarrolladores excelentes con un manejo de errores impecable que intentarán obtener nuevas credenciales ante una llamada a la API fallida, pero es poco probable, ya que no es un caso de uso común.
El código de la instancia sigue intentando usar el rol anterior porque no sabe que hay otra alternativa. En la opción 2 rompimos las cosas porque el IMDS no sabía que debía consultar a IAM para actualizar las credenciales. Esta vez el código no sabe que debe hablar con el IMDS para obtener nuevas credenciales.
Opción 4: insertar un VPC endpoint
Esta fue idea mía para ponerme creativo, y es de lejos la más complicada, pero funciona muy bien. Todas las instancias viven en una VPC (Virtual Private Cloud), que es su red virtual en AWS. Normalmente, todas las llamadas a la API salen por Internet para llegar a los endpoints públicos de AWS. De hecho, si tiene una instancia en una subred privada sin una ruta de salida a Internet, esas llamadas a la API fallarán.
Pues bien, eso es un problema bastante grande si quiere que su propia instancia privada se comunique con su propio bucket privado de S3. Antes teníamos que habilitar el acceso a Internet, lo que tiene costos y abre las cosas de maneras que los profesionales de seguridad preferimos minimizar.
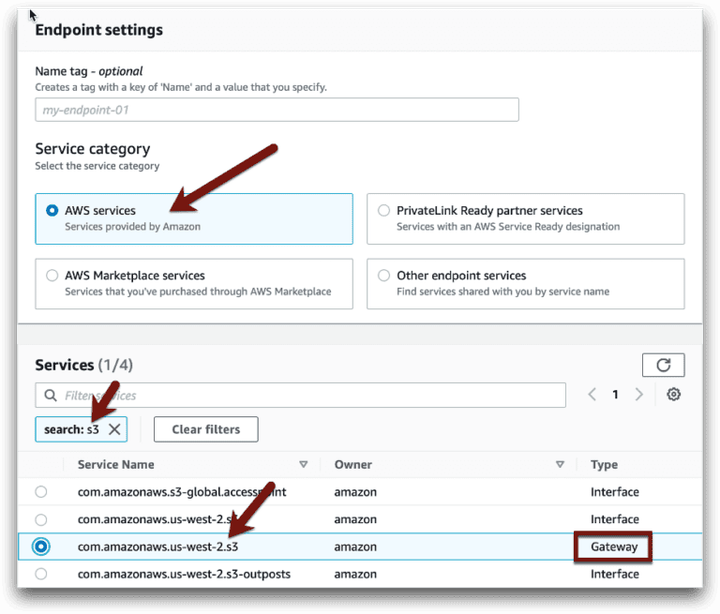
La respuesta de Amazon se conoce como Service Endpoint. Se trata de estructuras de enrutamiento internas, definidas por software, que puede configurar para permitir que los recursos de una VPC se comuniquen con endpoints de API (y otras cosas, pero esta no es la publicación para entrar en eso) enteramente dentro de la red interna de Amazon. Lo interesante es que, al usar un VPC endpoint, AWS inserta contexto adicional en el tráfico de red, ya que ahora puede incrustar datos en sus encabezados privados, ¡y podemos usar esto como condiciones en nuestras políticas de IAM!
Primero agregamos un VPC endpoint para S3 a la subred en la que está nuestra instancia:
Luego agregamos una condición a nuestra política de IAM que deniega todo el tráfico si no proviene de la VPC esperada. Así es como lo hacemos en el laboratorio de capacitación:
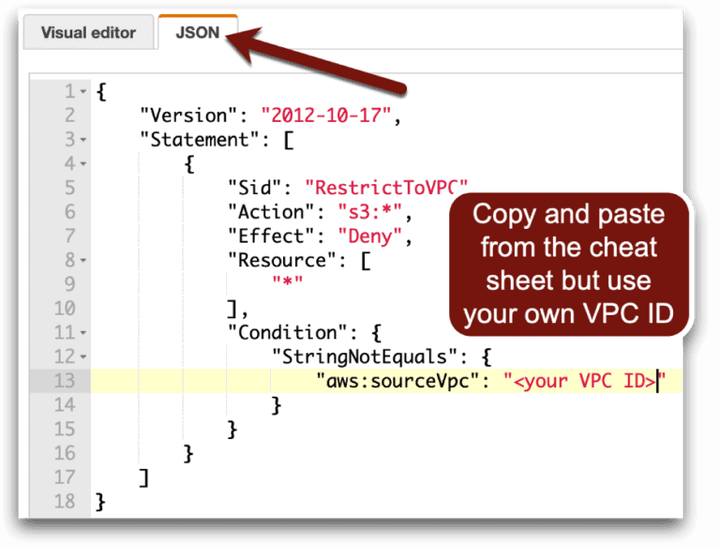
Si esto funciona, las llamadas a la API desde nuestra instancia seguirán funcionando, pero las credenciales fallarán si se usan desde cualquier lugar que no sea esta VPC (así que esperemos que el atacante no tenga acceso a otro recurso dentro de la VPC).
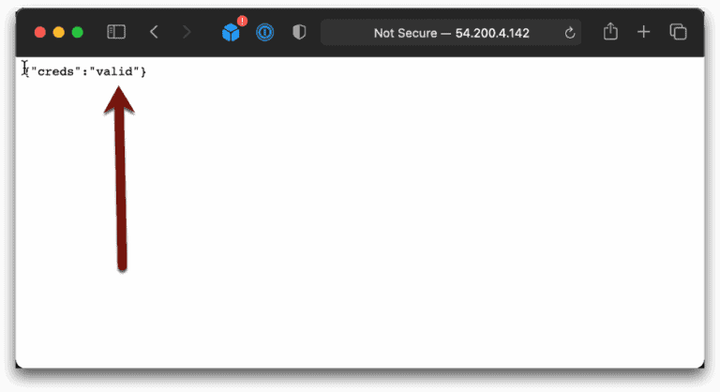
¡Excelente! Nuestras credenciales solo funcionarán desde dentro de la VPC y el atacante queda bloqueado. Así es EXACTAMENTE como funciona esa Service Control Policy que mencioné más arriba. El problema con la SCP es que los service endpoints agregan costos y complejidad, y activar esa política sin tener todos los endpoints correctos en su lugar romperá cosas, pero ahora a escala empresarial.
Un comportamiento inesperado
Como mencioné, construimos este laboratorio hace unos 2 años y por él han pasado un par de cientos de estudiantes. La semana pasada, Andre Rall de Uptycs publicó lo siguiente en una comunidad de seguridad en cloud en la que ambos participamos (usado con permiso):
¿Alguien sabe si esto debería estar ocurriendo? Tengo un rol adjunto a un instance profile que está asociado a una instancia. Cuando quito el rol del instance profile (mediante la CLI) pero mantengo el instance profile asociado a la instancia, la instancia todavía puede usar las credenciales del rol. Mi cabeza me dice que, como el rol no está adjunto, la instancia no debería poder seguir usándolo, pero tal vez se me está escapando algo.
Resulta que nos topamos otra vez con esa interacción entre servicios. Detrás de escena, un instance profile es lo que AWS usa para vincular un rol a una instancia en el servicio de metadatos. Andre quitó el rol del instance profile, pero el rol sigue existiendo y el instance profile también.
Uno pensaría que el IMDS no podría servir las credenciales, pero todavía TIENE las credenciales y no sabe qué pasó allá en el servicio IAM. Sigue sirviendo las credenciales y el rol sigue permitiéndolas, así que continúan funcionando. Revocar las credenciales SÍ funcionaría en este caso, porque el IMDS no podría obtener las nuevas credenciales después de desacoplar el instance profile y el rol.
La contención de credenciales de IAM tiene muchos matices, y este es solo un conjunto de ejemplos de un único servicio (EC2). Pero una vez que vea el flujo del servicio IAM interactuando con el IMDS y este con los SDK, obtendrá una base sólida en algunos de los principios fundamentales que puede aplicar en otras situaciones.
Y no olvide conocer el nivel gratuito de FireMon Cloud Defense que acabamos de lanzar.