Comprenda el riesgo de sus políticas. Haga preguntas sobre políticas en lenguaje natural. Solicitar un demo →
Published:
Los 2 mejores consejos de un paramédico para la respuesta a incidentes en el cloud
by Rich Mogull
Una de las ventajas de tener muchos pasatiempos distintos es que conectan el cerebro de una manera un poco diferente. Uno termina abordando los problemas desde otro ángulo, a medida que se produce una contaminación cruzada mental entre distintos dominios. Como paramédico semiactivo, encuentro muchísimos paralelos entre atender emergencias de carne y hueso y gestionar emergencias de bits y bytes.
He impartido muchas capacitaciones sobre respuesta a incidentes en el cloud durante los últimos años y empecé a usar dos frases del mundo paramédico que parecen resonar bien con quienes se inician en la respuesta a incidentes. Estas ayudas mnemotécnicas funcionan muy bien para afinar el enfoque y optimizar el proceso. Si bien aplican a cualquier respuesta a incidentes, considero que cumplen un papel mayor del lado del cloud debido a las diferencias inherentes causadas predominantemente por la existencia del plano de administración.
Grave o no grave
Los paramédicos podemos hacer mucho en comparación con cualquier persona de la calle, pero estamos bastante limitados en el ámbito de la medicina. Estamos sumamente entrenados para reconocer con rapidez las amenazas a la vida y a las extremidades, sean médicas o traumáticas, y para estabilizar y trasladar a los pacientes a la atención definitiva. Una frase clave que nos machacan es “grave o no grave”. Es una ayuda mnemotécnica que nos recuerda enfocarnos en el panorama general y determinar si el paciente está en serios problemas.
Me encanta usar esta frase para ayudar a los profesionales de seguridad de la información a evaluar qué tan grave es un incidente. Para el cloud, les enseñamos a identificar hallazgos significativos que exigen concentrarse en un problema en ese preciso momento antes de seguir adelante. En los servicios de emergencias médicas se le llama una “amenaza vital”. Dado que la respuesta a incidentes en el cloud aprovecha las habilidades de respuesta existentes con una nueva tecnología subyacente, esa frase es solo un recordatorio para considerar las consecuencias de un hallazgo que normalmente no activaría los instintos de quien responde. Aquí van algunos ejemplos simples:
- Datos hechos públicos en el almacenamiento de objetos (S3) que no deberían serlo.
- Una entidad IAM potencialmente comprometida con privilegios de administrador u otros privilegios elevados.
- Múltiples llamadas exitosas a la API usando distintos usuarios IAM desde la misma dirección IP desconocida.
- Uso compartido entre cuentas de una imagen o una instantánea con una cuenta desconocida.
- Una instancia o VM potencialmente comprometida que tiene privilegios IAM.
Cuando los escribo, la mayoría de quienes responden dicen: “obvio, eso es evidente”, pero según mi experiencia, quienes responden de forma tradicional necesitan un poco de tiempo para reconocer estos problemas y darse cuenta de que son mucho más críticos que una máquina virtual comprometida promedio.
“Grave o no grave” en el cloud casi siempre se traduce en “¿es público o se movieron al plano de administración (IAM)?”.
Grave o no grave. Cada vez que encuentre una nueva evidencia, una nueva pieza del rompecabezas, hágase esta pregunta para determinar si su paciente está por colapsar o si solo tiene un resfriado.
Detenga la hemorragia
Muchos de ustedes probablemente hayan tomado un curso de RCP y primeros auxilios. Es probable que hayan aprendido el “ABC”: vía aérea (Airway), respiración (Breathing) y circulación (Circulation).
Pues resulta que en eso nos equivocamos por completo.
Las investigaciones comenzaron a mostrar que, en una emergencia, la gente se concentraba en el ABC y dejaba de lado el panorama general. Incluso los paramédicos terminaban haciendo RCP a alguien que se desangraba por una herida en la pierna. A veces era una RCP perfecta. Se notaba por la rapidez con la que el paciente se quedaba sin sangre. Hoy en día agregamos “tratar la amenaza vital” al inicio, y “detener la hemorragia” es la máxima prioridad.
¿Ve hacia dónde voy?
En cada clase que he impartido, veo a personas con gran experiencia en respuesta concentradas en su análisis e investigación mientras el cloud se desangra frente a ellas. ¿Por qué?
Porque no están acostumbradas a que todo esté (potencialmente) en Internet. Todo el plano de administración está en Internet, así que si un atacante obtiene credenciales, no se le puede detener con un firewall ni cerrando el acceso a un servidor. Si algo está comprometido y expuesto, está comprometido y expuesto ante… bueno, potencialmente todos, en todas partes, al mismo tiempo.
Detener la hemorragia va de la mano con grave o no grave. Si encuentra algo grave, ¿necesita contenerlo en ese preciso momento antes de seguir adelante? Es un equilibrio delicado, porque si toma la decisión equivocada podría estar desperdiciando tiempo valioso mientras el atacante continúa avanzando. Detener la hemorragia equivale a “esto es tan malo que necesito resolverlo ahora”. Pero una vez que detenga la hemorragia, debe retomar de inmediato donde estaba y continuar con su proceso de análisis y respuesta, ya que puede quedar mucho más daño en curso.
¿Mi lista corta?
- Cualquier entidad IAM con privilegios elevados que parezca comprometida.
- Datos sensibles que de algún modo son públicos.
- Uso compartido entre cuentas, suscripciones o proyectos, o acceso a un destino desconocido.
Hay más, pero esa es la lista corta. Cada uno de estos casos indica pérdida de datos o compromiso activo, y debe contenerlos de inmediato.
Verlo en acción
Aquí va un ejemplo. Las capturas de pantalla son una mezcla de Slack, la consola de AWS y FireMon Cloud Defense. Esa es mi cadena de herramientas, y esto funcionará con lo que usted tenga. En las clases de capacitación también usamos consultas de Athena para simular un SIEM, pero quiero mantener esta publicación corta (más o menos).
Comencemos con una alerta de severidad media en Slack proveniente de nuestra plataforma combinada de CSPM/CDR:
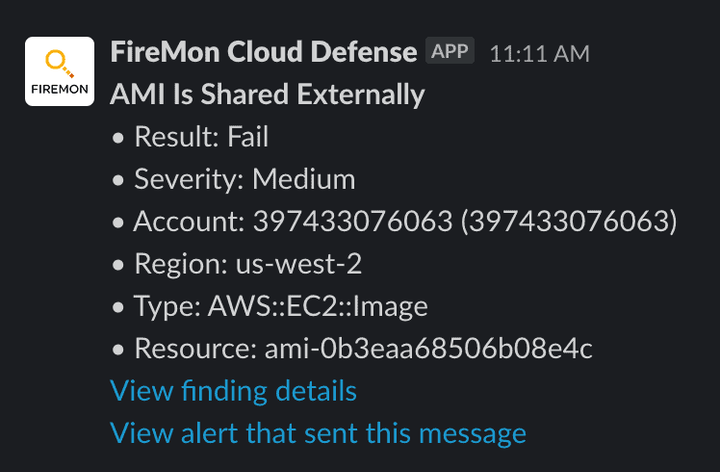
¿Grave o no grave? Aún no lo sabemos. Esto podría ser totalmente legítimo. Bien, es hora de investigar. Lo mostraré tanto en la plataforma como en la consola de AWS. Mi primer paso es ver qué se comparte y dónde. Como la alerta incluye el ID de la AMI, podemos ir directo a ella:
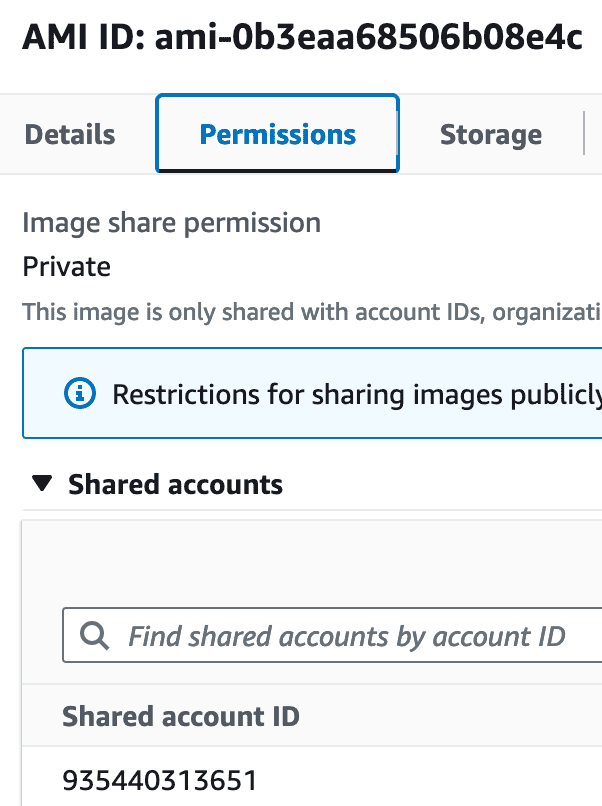
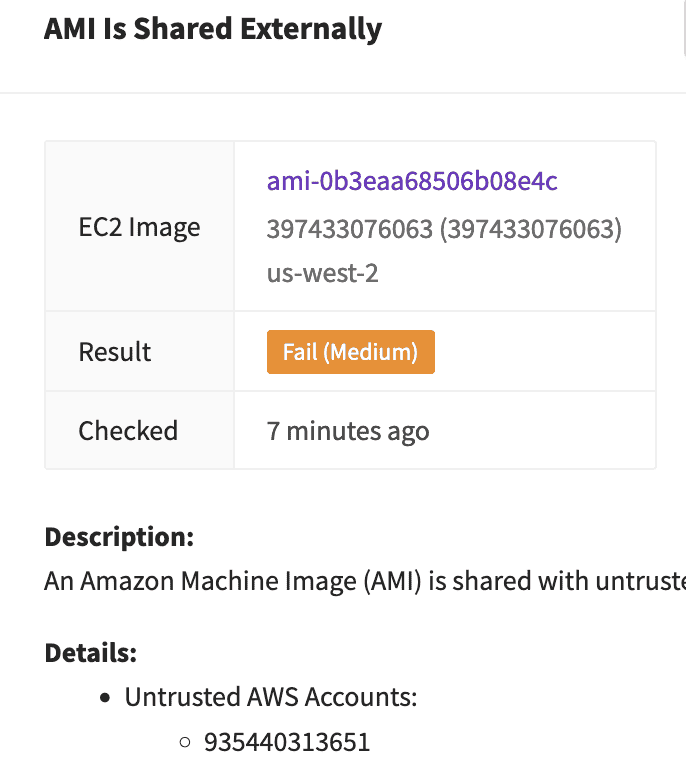
Bien: puedo ver que esto se comparte con otra cuenta. ¿Es una cuenta que me pertenece? ¿Que conozco? Mi herramienta la marca como no confiable porque no es una cuenta registrada en el sistema, pero en la vida real yo querría revisar la lista maestra de cuentas de mi organización solo para verificarlo.
Bien, ¿grave o no grave? En mi cabeza sigue siendo un quizá. Tengo una imagen compartida con una cuenta potencialmente no confiable. Pero todavía no sé qué es lo que se comparte. Necesito rastrearlo hasta la instancia de origen. No me voy a meter en un análisis forense completo; voy a apoyarme en información contextual, porque necesito resolver esto bastante rápido. En este caso, tuvimos suerte:
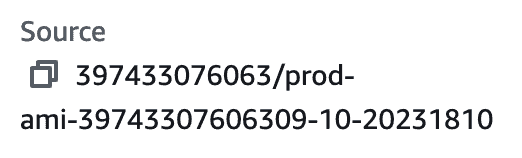
Tiene "Prod" en el nombre, así que… lo califico como “probablemente grave”. ¿Detener la hemorragia? En la vida real, primero intentaría contactar a quien fuera dueño de esa cuenta de AWS, pero por hoy considero que tengo información suficiente para poner la AMI en cuarentena. Así se hace en la consola y en Cloud Defense:
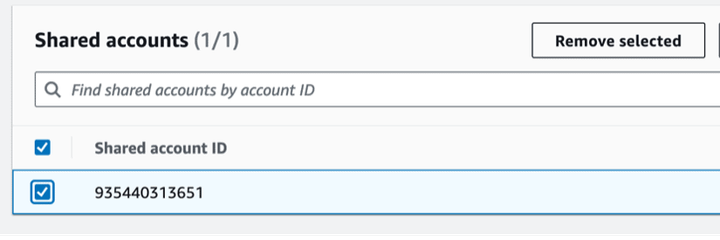
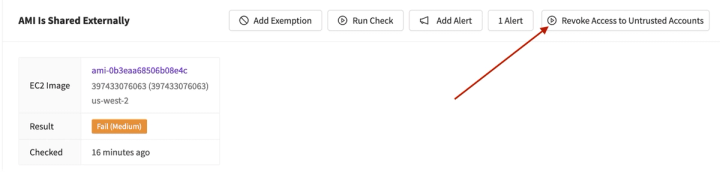
Bien, ¿detuvimos la hemorragia? Detuvimos… parte de la hemorragia. Bloqueamos la AMI, pero todavía no sabemos cómo llegó ahí. Tampoco sabemos quién es el dueño de esa cuenta de AWS. ¿Podemos averiguarlo? No. Si no es nuestra, lo único que podemos hacer es reportarla a AWS y dejar que ellos se encarguen del resto.
Busquemos las llamadas a la API para averiguar quién la compartió y qué más hizo. Voy a hacer estas partes siguientes en la plataforma, pero usted ejecutaría consultas en su SIEM o en Athena para encontrar la misma información. En futuras publicaciones abordaré todas las consultas, pero esta publicación se centra en los conceptos de grave y hemorragia.
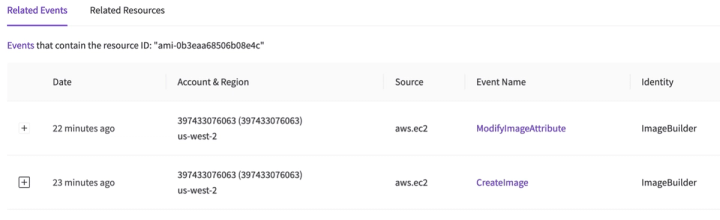
Bien: veo que una entidad IAM llamada ImageBuilder es la responsable. De nuevo, dado que esta publicación ya se está alargando, revisé algunas cosas y esto es lo que descubrí:
- ImageBuilder es un usuario IAM con privilegios para crear imágenes y modificar sus atributos, pero nada más. Sin embargo, la política no tiene restricciones de recursos, por lo que puede crear una imagen de cualquier instancia. Y no tiene restricciones condicionales, por lo que puede compartir con cualquier cuenta. Este es un radio de impacto de moderado a bajo: tiene privilegios excesivos, pero no de forma terrible. Yo lo llamo algo grave.
- La llamada a la API provino de una dirección IP desconocida. Esto es sospechoso, pero sigue siendo solo algo grave.
- Es la primera vez que veo esa dirección IP usada por este usuario IAM, y el usuario muestra actividad previa alineada con un proceso por lotes. Bien, ahora me inclino por grave. Normalmente no vemos direcciones IP rotativas para trabajos como este; huele a credencial perdida:
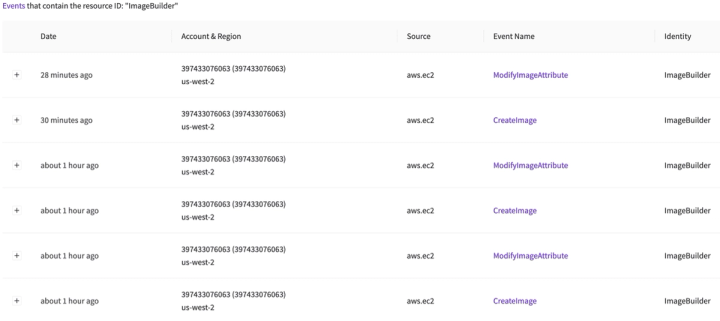
- Ese usuario IAM puede seguir realizando estas acciones. A menos que alguien me diga que la intención era hacer esto, lo califico como grave y voy a Detenga la hemorragia y poner una restricción IAM en esa cuenta de usuario (probablemente una política Deny All, a menos que sea un proceso crítico, y entonces usaría una restricción por IP).
En resumen:
- Encontré una AMI compartida con una cuenta desconocida: grave
- Esa AMI correspondía a un activo de producción: grave y detener la hemorragia
- La acción provino de un usuario IAM con amplios privilegios para crear AMI y compartirlas, pero nada más: quizá grave, aún en investigación.
- El usuario IAM creó esa AMI desde una dirección IP nueva y desconocida: grave, detener (el resto de) la hemorragia.
- No hay ninguna otra actividad detectada desde la dirección IP: Probablemente contenido y ya no es Grave
- Sigo sin saber cómo se filtraron esas credenciales: Grave, y es momento de recurrir a nuestros colegas tradicionales de respuesta a incidentes para determinar si hubo un compromiso de red o de host.
Revisé esto rápidamente para mostrar cómo pienso sobre estos problemas. Con apenas unas pocas diferencias, este mismo hallazgo habría sido totalmente normal. Imagine que nos diéramos cuenta de que se compartió con una cuenta nueva que controlamos pero que aún no estaba registrada. O que la AMI correspondía a una instancia de desarrollo que no contiene nada sensible. O que las llamadas a la API provinieron de nuestra red, a la hora esperada, o desde el sistema de un administrador que tenía la intención de compartirla. Este ejemplo no es escandaloso, pero sí es una forma conocida de exfiltración de datos utilizada por actores de amenazas activos. A medida que encuentro cada dato, evalúo si es Grave o No Grave y si necesito Detener la Hemorragia.
¿En qué se diferencia esto en el cloud? En que lo que está en juego es mayor cuando todo puede llegar a estar expuesto a Internet. Debemos pensar y actuar más rápido, y considero que esta regla mnemotécnica resulta útil para mantenernos enfocados.