Policy-Risiken verstehen. Fragen zu Policies in natürlicher Sprache stellen. Demo anfragen →
Published:
Kompromittierte EC2-Anmeldedaten eindämmen, ohne (hoffentlich) etwas zu zerstören
by FireMon
Es gibt mehrere Techniken, um kompromittierte Instanz-Anmeldeinformationen einzudämmen. Die einfachen Methoden führen am ehesten zu Störungen, doch es gibt kreative Optionen, um Angreifer auszusperren, ohne Anwendungen zu beeinträchtigen.
In den vergangenen Jahren hat Amazon einige bedeutende Fortschritte erzielt, um das Risiko zu verringern, dass ein Angreifer Anmeldeinformationen stiehlt und missbraucht, die AWS-Instanzen zugewiesen sind. Gut, vieles davon geschah nach jener wirklich großen Sicherheitsverletzung, über die alle noch immer sprechen, aber inzwischen stehen uns weitaus bessere Werkzeuge zur Verfügung, um diese Art von Angriff zu verhindern. Dennoch ist sie nach wie vor sehr verbreitet und steht auf jeder Liste der Cloud-Bedrohungen weit oben.
Im vergangenen Monat hat AWS einige neue Richtlinienoptionen zur Absicherung von Instanz-Anmeldeinformationen veröffentlicht, was die Idee zu diesem Beitrag angestoßen hat. Das und eine interessante Entdeckung aus der Cloud-Security-Community, auf die ich gleich eingehen werde. So gut diese neue Funktion auch ist – zusammen mit den von AWS deutlich verbesserten GuardDuty-Erkennungen für die Exfiltration von Anmeldeinformationen –, irgendwann erhalten Sie möglicherweise eine Warnmeldung von einem Tool wie dem unseren und müssen Ihren Incident-Response-Prozess in Gang setzen:
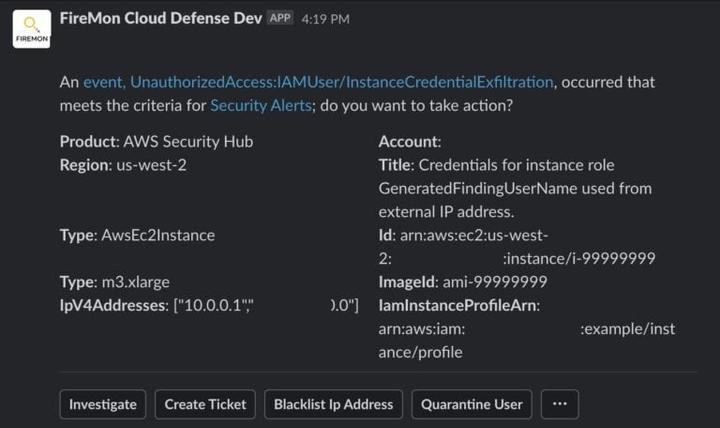
Im Laufe der Jahre habe ich eine Reihe von Eindämmungsoptionen zusammengetragen und getestet, für die ich größtenteils Labs in der Cloud-Incident-Response-Schulung habe, die ich gemeinsam mit Will Bengtson erstellt habe. Es gibt überraschend viele Feinheiten dabei, den Angreifer einzudämmen, ohne etwas kaputtzumachen. Bei der Arbeit mit Instanz-Anmeldeinformationen interagieren Sie faktisch mit drei Komponenten: dem IAM-Service, der die Berechtigungen verwaltet, dem Instance Metadata Service (IMDS), der diese Anmeldeinformationen an die Instanz übergibt, und dem Code bzw. SDK, das Ihre Anwendung innerhalb der Instanz ausführt und die Anmeldeinformationen nutzt. Beachten Sie, dass ich manches bewusst vereinfache und Service Control Policies sowie Resource- bzw. Bucket-Richtlinien außer Acht lasse. (Alle Screenshots in diesem Beitrag sind dreist aus meiner eigenen Schulung entwendet – bitte melden Sie mich also nicht den Behörden.)
Und kurz zum Hintergrund für alle, die es nicht wissen: Wenn Sie einer Instanz eine IAM-Rolle zuweisen, erhält diese Instanz automatisch rotierende Anmeldeinformationen, die ihr die Berechtigungen dieser Rolle verleihen. Wenn ein Angreifer jedoch auf irgendeine Weise auf die Instanz zugreifen kann, etwa über einen SSRF-Angriff oder das Brute-Forcing von SSH, kann er diese Anmeldeinformationen kopieren und außerhalb von AWS oder aus einem von ihm kontrollierten AWS-Konto verwenden.
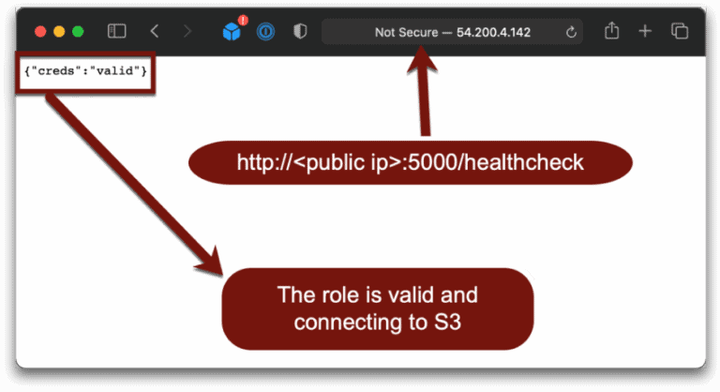
Zur Vorbereitung hat Will eine kleine Anwendung geschrieben, die versucht, eine interne Verbindung zu einem S3-Bucket herzustellen, und zurückmeldet, ob die Anmeldeinformationen gültig sind (nein, die gezeigten IP-Adressen sind nicht mehr gültig):
Option 1: Eine Deny-All-Richtlinie zur Rolle hinzufügen
Das ist mit Abstand der einfachste und schnellste Weg. Durch das Hinzufügen einer Deny-All-Richtlinie zur IAM-Rolle schlagen alle API-Aufrufe fehl und der Angreifer kann keinen weiteren Schaden anrichten.
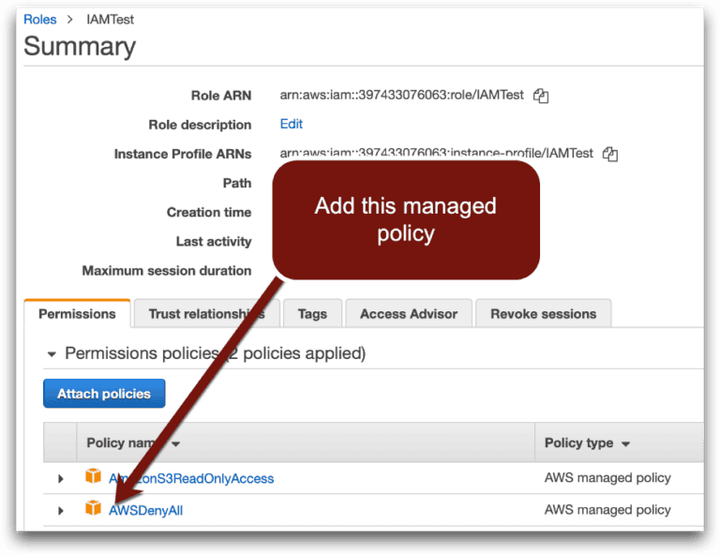
Das ist schnell, einfach und eine sehr zügige Methode, um Ihre Anwendung lahmzulegen, denn dadurch werden auch alle legitimen API-Aufrufe unterbunden:
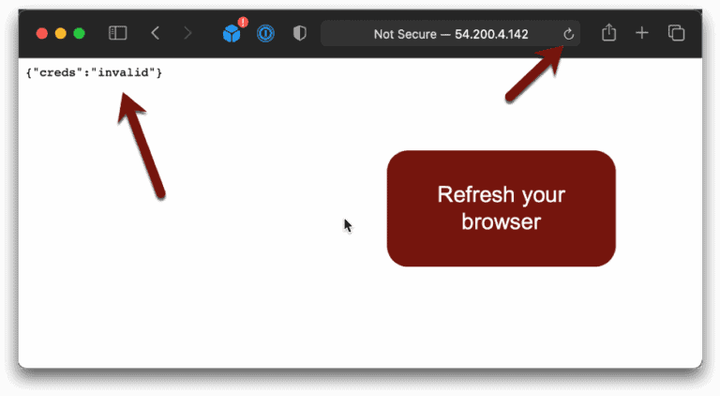
Denken Sie daran: Unser Ziel ist es, den Angreifer auszusperren, ohne unsere legitim laufenden Anwendungen zu beeinträchtigen.
Hoppla.
Option 2: Die Sitzung widerrufen
AWS bietet eine nützliche Funktion zum Widerrufen aktiver Sitzungen. Mit einem Klick auf eine Schaltfläche in der Konsole können Sie eine benutzerdefinierte Deny-All-Richtlinie hinzufügen, die den Zugriff nur für Sitzungen verweigert, die vor dem beim Klick gesetzten Zeitpunkt begonnen haben (dafür gibt es keinen einfachen API-Aufruf, aber es ist nicht schwierig, eine eigene Richtlinie mit derselben Wirkung zu schreiben).
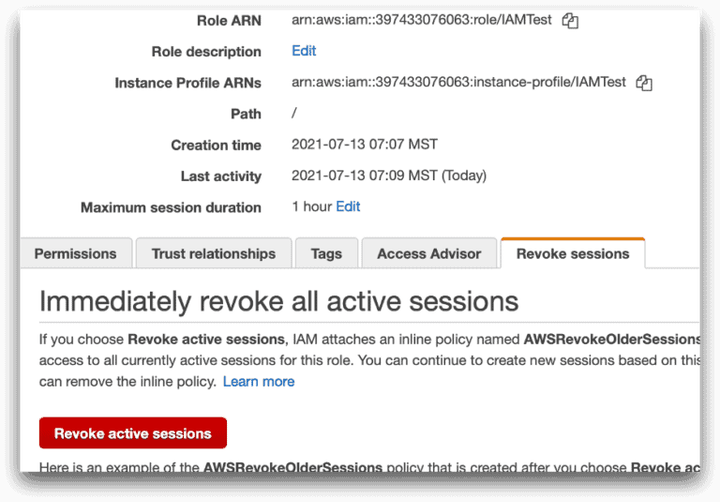
Angenommen, Sie haben verhindert, dass der Angreifer die neue Sitzung kompromittiert, würde er dadurch theoretisch ausgesperrt, weil die gestohlenen Anmeldeinformationen ablaufen, während Ihre Anwendung mit neuen weiterarbeitet. Aber …
Nein. Hoppla Nummer 2. Warum?
Der IMDS aktualisiert die Anmeldeinformationen erst, wenn sie ablaufen. IMDS ist ein anderer Dienst als IAM und weiß nicht, dass Sie Anmeldeinformationen widerrufen haben; er hat weder Grund noch Anlass, die neuen Anmeldeinformationen abzurufen und der Instanz bereitzustellen. Er liefert die widerrufenen Anmeldeinformationen bis zum Ende der Sitzung weiter aus.
Option 3: Die IAM-Rolle wechseln und die alte Rolle sperren
Jetzt wird es raffinierter. Was wäre, wenn wir eine neue Rolle erstellen, die Instanz auf die neue Rolle umstellen und die alte blockieren? Wie zuvor funktioniert das nur, wenn Sie sicher sind, dass der Angreifer nicht einfach die Anmeldeinformationen der neuen Rolle stehlen kann.
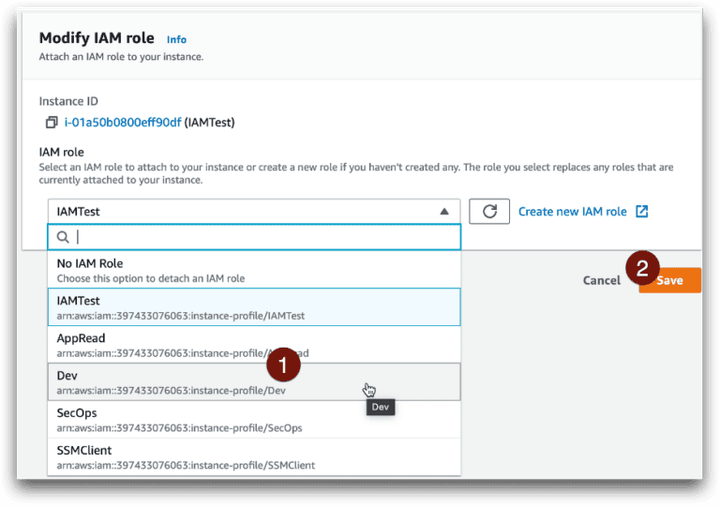
Nein. Hoppla Nummer 3. Was passiert hier also?
Die meisten Codes und SDKs bauen beim Start eine IAM-Sitzung auf und rufen die Anmeldeinformationen vom Metadatendienst ab. Diese Anmeldeinformationen haben eine Sitzungsdauer, vergleichbar mit einer Time to Live (TTL). Die Anmeldeinformationen werden im Arbeitsspeicher gehalten und bis kurz vor Ablauf dieser Dauer verwendet. Bei Verwendung der Boto-Bibliothek in Python (die wir für diese Demo eingesetzt haben) sucht der Code beispielsweise erst 15 Minuten vor Ablauf der Anmeldeinformationen nach neuen.
Die Anwendung schlägt also so lange fehl, bis sie nach aktualisierten Anmeldeinformationen sucht. Je nach Konfiguration geschieht dies in einer EC2-Instanz standardmäßig meist alle 6 Stunden. Gut, vielleicht haben Sie hervorragende Entwickler mit exzellenter Fehlerbehandlung, die bei einem fehlgeschlagenen API-Aufruf versuchen, neue Anmeldeinformationen abzurufen – das ist jedoch unwahrscheinlich, da es kein gängiger Anwendungsfall ist.
Der Code in der Instanz versucht weiterhin, die alte Rolle zu verwenden, weil er es nicht besser weiß. Bei Option 2 kam es zu Störungen, weil der IMDS nicht wusste, dass er bei IAM nach aktualisierten Anmeldeinformationen fragen muss. Diesmal weiß der Code nicht, dass er mit dem IMDS kommunizieren muss, um neue Anmeldeinformationen zu erhalten.
Option 4: Einen VPC-Endpunkt einfügen
Hier wollte ich es besonders raffiniert angehen; es ist mit Abstand die komplizierteste Variante, funktioniert aber sehr gut. Alle Instanzen befinden sich in einer VPC (Virtual Private Cloud), ihrem virtuellen Netzwerk in AWS. Normalerweise laufen alle API-Aufrufe über das Internet zu den öffentlichen AWS-Endpunkten. Wenn Sie eine Instanz in einem privaten Subnetz ohne ausgehende Route ins Internet betreiben, schlagen diese API-Aufrufe sogar fehl.
Nun, das ist ein ziemliches Problem, wenn Ihre eigene private Instanz mit Ihrem eigenen privaten S3-Bucket kommunizieren soll. Früher mussten wir dafür den Internetzugang aktivieren, was Kosten verursacht und Dinge auf eine Weise öffnet, die wir Sicherheitsfachleute möglichst vermeiden.
Amazons Antwort darauf ist der sogenannte Service Endpoint. Dabei handelt es sich um interne, softwaredefinierte Routing-Strukturen, die Sie so konfigurieren können, dass Ressourcen in einer VPC mit API-Endpunkten (und anderem, worauf ich in diesem Beitrag nicht eingehe) vollständig über Amazons internes Netzwerk kommunizieren. Das Interessante daran: Bei Verwendung eines VPC-Endpunkts fügt AWS dem Netzwerkverkehr zusätzlichen Kontext hinzu, da nun Daten in den privaten Headern eingebettet werden können – und diese können wir als Bedingungen in unseren IAM-Richtlinien nutzen!
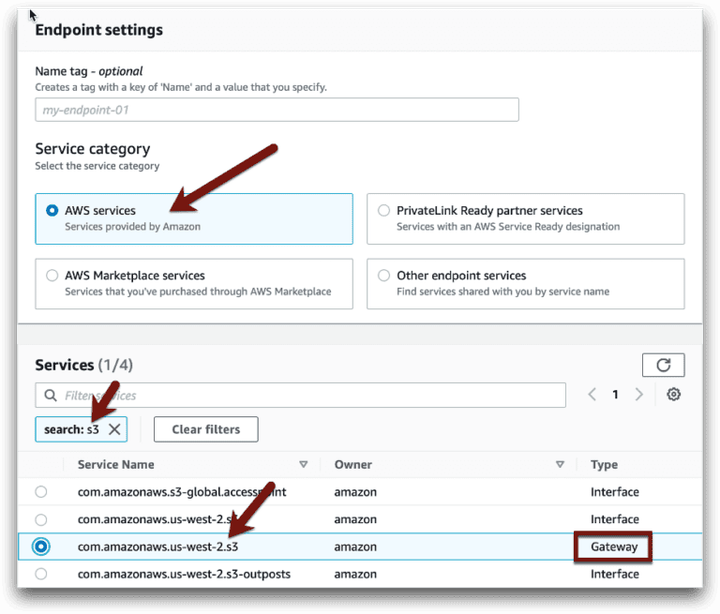
Zunächst fügen wir dem Subnetz, in dem sich unsere Instanz befindet, einen VPC-Endpunkt für S3 hinzu:
Anschließend fügen wir unserer IAM-Richtlinie eine Bedingung hinzu, die jeglichen Datenverkehr verweigert, der nicht aus der erwarteten VPC stammt. So machen wir es im Schulungslab:
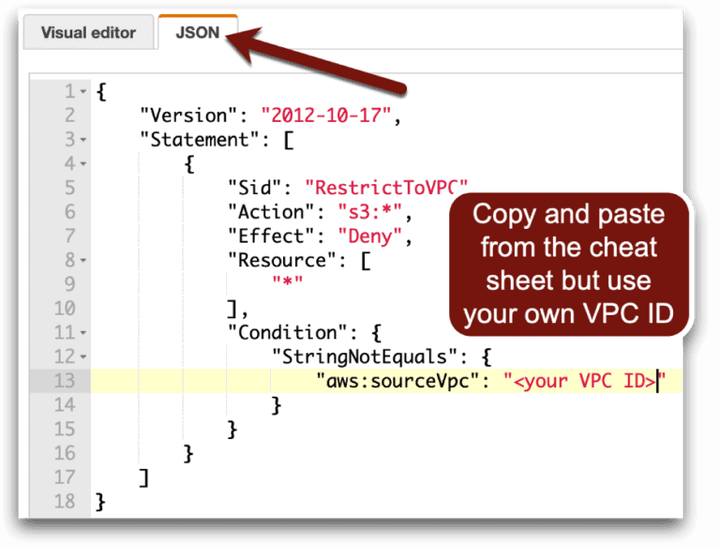
Wenn das funktioniert, laufen API-Aufrufe von unserer Instanz weiterhin, doch die Anmeldeinformationen schlagen fehl, sobald sie von außerhalb dieser VPC verwendet werden (hoffen wir also, dass der Angreifer keinen Zugriff auf eine andere Ressource in der VPC hat).
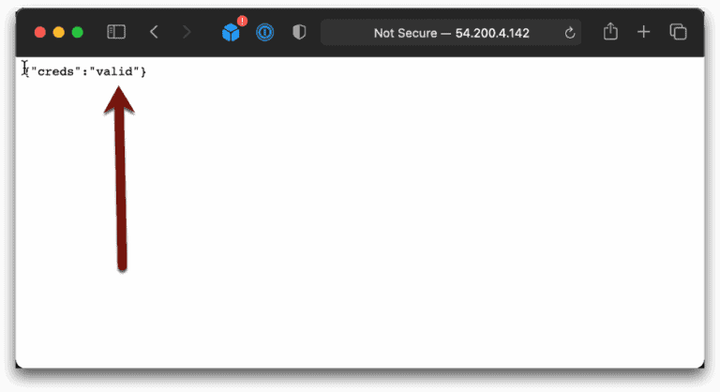
Geschafft! Unsere Anmeldeinformationen funktionieren nur innerhalb der VPC und der Angreifer ist ausgesperrt. Genau so arbeitet die weiter oben erwähnte Service Control Policy. Das Problem bei der SCP ist, dass Service-Endpunkte Kosten und Komplexität verursachen und das Aktivieren dieser Richtlinie ohne alle erforderlichen Endpunkte zu Störungen führt – dann allerdings im Unternehmensmaßstab.
Ein unerwartetes Verhalten
Wie erwähnt haben wir dieses Lab vor etwa 2 Jahren aufgebaut und seither einige hundert Teilnehmende hindurchgeführt. Vergangene Woche schrieb Andre Rall von Uptycs Folgendes in einer Cloud-Security-Community, in der wir beide aktiv sind (mit Genehmigung verwendet):
Weiß jemand, ob das so sein sollte? Ich habe eine Rolle, die an ein Instanzprofil angehängt ist, das wiederum einer Instanz zugeordnet ist. Wenn ich die Rolle aus dem Instanzprofil entferne (per CLI), das Instanzprofil aber weiterhin der Instanz zugeordnet bleibt, kann die Instanz die Anmeldeinformationen der Rolle weiterhin verwenden. Mein Verstand sagt mir, dass die Instanz sie nicht weiter nutzen können sollte, da die Rolle nicht mehr angehängt ist – aber vielleicht übersehe ich etwas.
Es zeigt sich, dass wir hier erneut auf diese Dienst-Interaktion stoßen. Im Hintergrund ist ein Instanzprofil das, womit AWS im Metadatendienst eine Rolle mit einer Instanz verknüpft. Andre hat die Rolle aus dem Instanzprofil entfernt, doch die Rolle existiert weiterhin und das Instanzprofil ebenfalls.
Man würde annehmen, der IMDS könne die Anmeldeinformationen nicht mehr ausliefern, doch er HAT sie weiterhin und weiß nicht, was im IAM-Service geschehen ist. Er liefert die Anmeldeinformationen weiterhin aus, und die Rolle lässt sie weiterhin zu – also funktionieren sie. Ein Widerrufen der Anmeldeinformationen WÜRDE in diesem Fall funktionieren, da der IMDS nach der Entkopplung von Instanzprofil und Rolle keine neuen Anmeldeinformationen mehr beziehen könnte.
Das Eindämmen von IAM-Anmeldeinformationen hat viele Feinheiten, und dies ist nur eine Reihe von Beispielen aus einem einzigen Dienst (EC2). Sobald Sie jedoch den Ablauf verstehen, wie der IAM-Service mit dem IMDS und dieser wiederum mit SDKs interagiert, verfügen Sie über ein solides Fundament einiger Kernprinzipien, die Sie auch in anderen Situationen anwenden können.
Und vergessen Sie nicht, sich die soeben eingeführte FireMon Cloud Defense Free-Tier anzusehen.