Policy-Risiken verstehen. Fragen zu Policies in natürlicher Sprache stellen. Demo anfragen →
Published:
Die 2 wichtigsten Tipps eines Rettungssanitäters für Cloud Incident Response
by Rich Mogull
Einer der Vorteile vieler ungewöhnlicher Hobbys ist, dass sie das Gehirn etwas anders verdrahten. Man nähert sich Problemen aus einem anderen Blickwinkel, weil man verschiedene Fachgebiete gedanklich miteinander vermischt. Als semi-aktiver Rettungssanitäter finde ich zahllose Parallelen zwischen dem Einsatz bei Notfällen aus Fleisch und Blut und dem Umgang mit Notfällen aus Bits und Bytes.
In den vergangenen Jahren habe ich viel zum Thema Cloud Incident Response unterrichtet und dabei begonnen, zwei Formulierungen aus der Welt der Rettungsdienste zu verwenden, die bei angehenden Incident Respondern gut ankommen. Diese Merkhilfen eignen sich gut dazu, den Fokus zu schärfen und den Prozess zu optimieren. Sie gelten zwar für jede Form der Incident Response, doch auf der Cloud-Seite spielen sie meiner Erfahrung nach eine größere Rolle, da dort systembedingte Unterschiede bestehen, die vor allem auf die Existenz der Management-Ebene zurückgehen.
Krank oder nicht krank
Rettungssanitäter können im Vergleich zu einem Laien eine ganze Menge, doch im Bereich der Medizin sind wir ziemlich eingeschränkt. Wir sind hervorragend darin ausgebildet, Gefahren für Leib und Leben rasch zu erkennen – ob medizinisch oder traumatisch bedingt –, Patienten zu stabilisieren und in die definitive Versorgung zu transportieren. Ein zentraler Satz, der uns eingebläut wird, lautet: „krank oder nicht krank“. Er ist eine Merkhilfe, die uns daran erinnert, das Gesamtbild im Blick zu behalten und zu erkennen, ob der Patient in ernster Gefahr schwebt.
Ich nutze diesen Satz gern, um Informationssicherheitsfachleuten dabei zu helfen, den Schweregrad eines Vorfalls einzuschätzen. Für die Cloud bringen wir ihnen bei, wesentliche Feststellungen zu erkennen, bei denen sie sich sofort auf ein Problem konzentrieren müssen, bevor sie weitermachen. Im Rettungsdienst spricht man von einer „Lebensbedrohung“. Da Cloud Incident Response auf vorhandenen IR-Fähigkeiten aufbaut, aber eine neue zugrunde liegende Technologie betrifft, ist dieser Satz lediglich eine Erinnerung daran, die Konsequenzen einer Feststellung zu bedenken, die normalerweise vielleicht nicht die Instinkte eines Responders weckt. Hier einige einfache Beispiele:
- Daten im Objektspeicher (S3), die öffentlich zugänglich gemacht wurden, obwohl sie es nicht sein sollten.
- Eine möglicherweise kompromittierte IAM-Entität mit Administrator- oder anderen weitreichenden Berechtigungen.
- Mehrere erfolgreiche API-Aufrufe mit unterschiedlichen IAM-Benutzern von derselben unbekannten IP-Adresse.
- Kontoübergreifende Freigabe eines Images oder Snapshots an ein unbekanntes Konto.
- Eine möglicherweise kompromittierte Instanz/VM mit IAM-Berechtigungen.
Wenn ich diese Punkte aufschreibe, sagen die meisten Responder: „Klar, das ist doch offensichtlich.“ Meiner Erfahrung nach brauchen klassische Responder jedoch etwas Zeit, um diese Probleme zu erkennen und zu begreifen, dass sie weit kritischer sind als eine durchschnittliche kompromittierte virtuelle Maschine.
„Krank oder nicht krank“ bedeutet in der Cloud fast immer: „Ist es öffentlich, oder ist der Angreifer in die Management-Ebene (IAM) vorgedrungen?“
Krank oder nicht krank. Jedes Mal, wenn Sie ein neues Beweisstück finden, ein neues Puzzleteil, gehen Sie diese Frage im Kopf durch, um herauszufinden, ob Ihr Patient kurz vor dem Kollaps steht oder nur einen Schnupfen hat.
Blutung stoppen
Viele von Ihnen haben vermutlich schon einmal einen Erste-Hilfe- und Reanimationskurs besucht. Wahrscheinlich haben Sie dort die „ABCs“ gelernt: Atemweg, Beatmung und Kreislauf.
Tja, wie sich herausstellt, haben wir das gründlich vermasselt.
Untersuchungen zeigten, dass sich Menschen im Notfall so stark auf die ABCs konzentrieren, dass sie das Gesamtbild aus den Augen verlieren. Selbst Rettungssanitäter wurden dabei erwischt, jemanden zu reanimieren, der aus einer Beinwunde verblutete. Manchmal war es eine perfekte Reanimation. Man erkannte es daran, wie schnell dem Patienten das Blut ausging. Heute stellen wir „Lebensbedrohung behandeln“ voran, und „Blutung stoppen“ hat oberste Priorität.
Sie ahnen, worauf ich hinauswill?
In jeder Schulung, die ich gehalten habe, erlebe ich hocherfahrene Responder, die sich auf ihre Analyse und Untersuchung konzentrieren, während die Cloud vor ihren Augen verblutet. Warum?
Weil sie es nicht gewohnt sind, dass (potenziell) alles im Internet steht. Die gesamte Management-Ebene ist im Internet erreichbar. Wenn ein Angreifer also Zugangsdaten erlangt, können Sie ihn weder mit einer Firewall noch durch das Abschalten des Zugriffs auf einen Server stoppen. Wenn etwas kompromittiert und exponiert ist, dann ist es kompromittiert und exponiert gegenüber … nun ja, potenziell allen, überall und gleichzeitig.
Blutung stoppen geht Hand in Hand mit krank oder nicht krank. Wenn Sie etwas Krankes finden: Müssen Sie es sofort eindämmen, bevor Sie weitermachen? Das ist eine heikle Abwägung, denn bei einer Fehlentscheidung verlieren Sie womöglich kostbare Zeit, während der Angreifer weiter vorankommt. Blutung stoppen heißt: „Das ist so schlimm, dass ich es jetzt beheben muss.“ Doch sobald Sie die Blutung gestoppt haben, müssen Sie unmittelbar dort weitermachen, wo Sie aufgehört haben, und Ihre Analyse und Ihren Response-Prozess fortsetzen, denn es kann noch viel Schlimmes im Gange sein.
Meine Kurzliste?
- Jede IAM-Entität mit weitreichenden Berechtigungen, die kompromittiert erscheint.
- Sensible Daten, die auf irgendeine Weise öffentlich zugänglich sind.
- Konto-, Abonnement- oder projektübergreifende Freigaben oder Zugriffe auf ein unbekanntes Ziel.
Es gibt noch mehr, aber das ist die Kurzliste. Jeder dieser Punkte weist auf einen aktiven Datenverlust oder eine aktive Kompromittierung hin und muss sofort eingedämmt werden.
Das Ganze in der Praxis
Hier ein Beispiel. Die Screenshots stammen aus Slack, der AWS Console und FireMon Cloud Defense. Das ist meine Toolchain, und das Vorgehen funktioniert mit jeder anderen genauso. In den Schulungen nutzen wir außerdem Athena-Abfragen, um ein SIEM zu simulieren, doch ich möchte diesen Beitrag halbwegs kurz halten.
Beginnen wir mit einer Warnung mittleren Schweregrads in Slack aus unserer kombinierten CSPM-/CDR-Plattform:
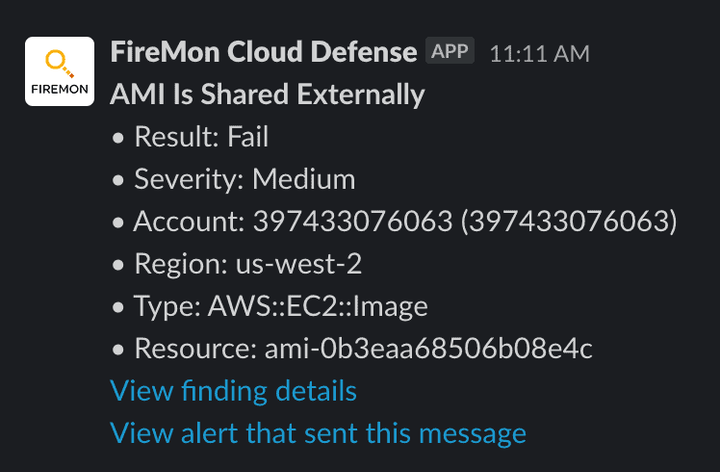
Krank oder nicht krank? Das wissen wir noch nicht. Es könnte völlig legitim sein. Gut, Zeit für eine Untersuchung. Ich zeige das sowohl in der Plattform als auch in der AWS Console. Mein erster Schritt ist zu sehen, was wo freigegeben ist. Da die Warnung die AMI-ID enthält, können wir direkt dorthin springen:
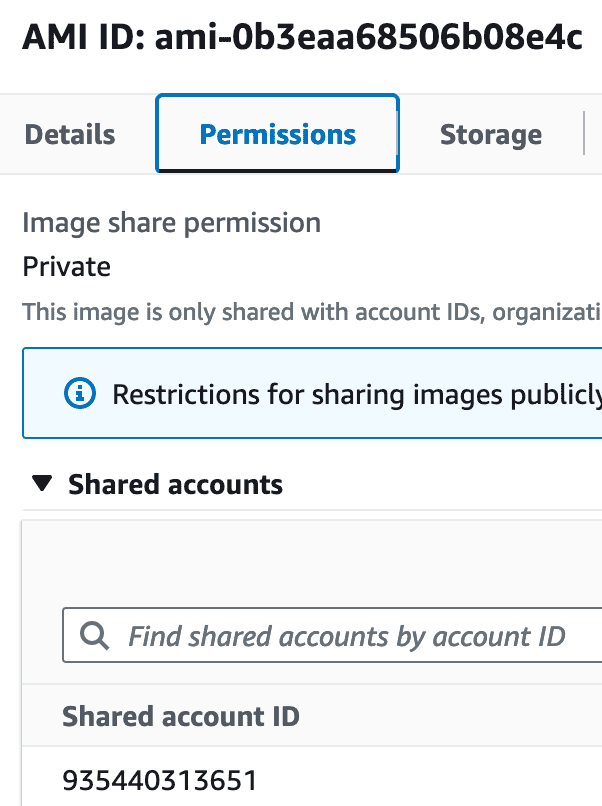
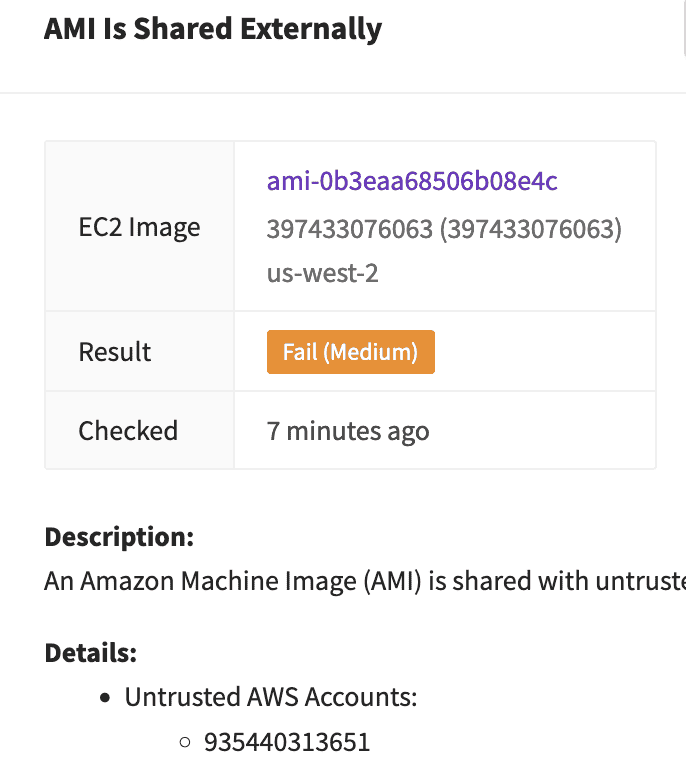
Gut – ich sehe, dass dies mit einem anderen Konto geteilt wird. Ist das ein Konto, das mir gehört? Das ich kenne? Mein Tool markiert es als nicht vertrauenswürdig, da es kein im System registriertes Konto ist, doch in der Praxis würde ich zur Sicherheit die zentrale Kontoliste meiner Organisation prüfen.
Also, krank oder nicht krank? In meinem Kopf ist es noch ein Vielleicht. Ich habe ein Image, das mit einem möglicherweise nicht vertrauenswürdigen Konto geteilt wurde. Aber ich weiß noch nicht, was da geteilt wurde. Ich muss es zur Ursprungsinstanz zurückverfolgen. Eine vollständige Forensik spare ich mir; ich verlasse mich auf Kontextinformationen, da ich das ziemlich schnell klären muss. In diesem Fall hatten wir Glück:
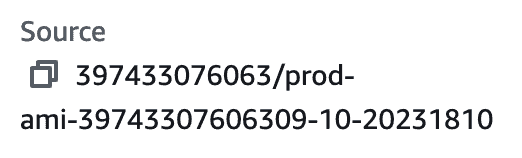
Der Name enthält „Prod“, also … nenne ich das „wahrscheinlich krank“. Blutung stoppen? In der Praxis würde ich zuerst versuchen, den Eigentümer dieses AWS-Kontos zu kontaktieren, aber für heute habe ich meines Erachtens genug Informationen, um das AMI unter Quarantäne zu stellen. So geht es in der Console und in Cloud Defense:
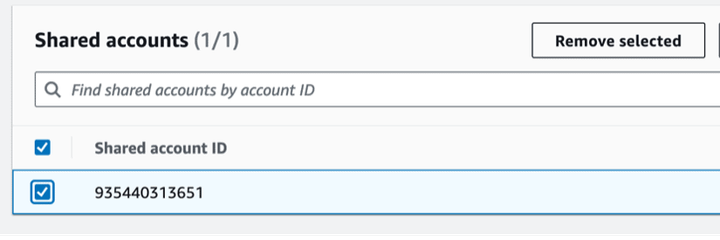
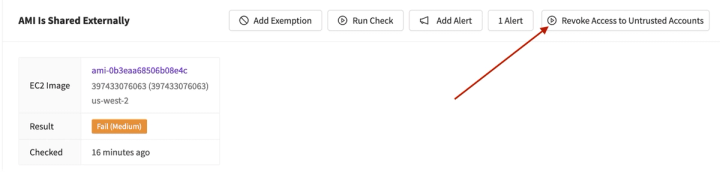
Gut, haben wir damit die Blutung gestoppt? Wir haben … einen Teil der Blutung gestoppt. Wir haben das AMI gesperrt, wissen aber immer noch nicht, wie es dorthin gelangt ist. Wir wissen auch nicht, wem dieses AWS-Konto gehört. Können wir das herausfinden? Nein. Wenn es nicht unseres ist, können wir es nur AWS melden und den Rest dort abwickeln lassen.
Suchen wir nach den API-Aufrufen, um herauszufinden, wer das Image freigegeben hat und was sonst noch getan wurde. Die nächsten Schritte führe ich in der Plattform aus, doch Sie würden dieselben Informationen über Abfragen in Ihrem SIEM oder in Athena ermitteln. Zu allen Abfragen folgen künftige Beiträge; dieser Beitrag konzentriert sich auf die Konzepte „krank“ und „Blutung“.
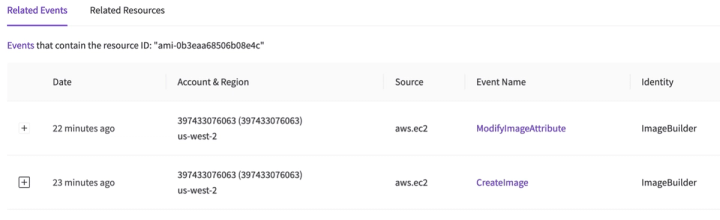
Gut – ich sehe, dass eine IAM-Entität namens ImageBuilder dafür verantwortlich ist. Da dieser Beitrag ohnehin schon lang wird: Ich habe einige Dinge geprüft und Folgendes herausgefunden:
- ImageBuilder ist ein IAM-Benutzer mit Berechtigungen zum Erstellen von Images und zum Ändern ihrer Attribute, aber nicht mehr. Allerdings enthält die Richtlinie keine Ressourcenbeschränkungen, sodass ein Image jeder beliebigen Instanz erstellt werden kann. Und keine bedingten Einschränkungen, sodass die Freigabe an jedes beliebige Konto möglich ist. Das ist ein mittlerer bis geringer Wirkungsradius – überprivilegiert, aber nicht dramatisch. Ich nenne das halbwegs krank.
- Der API-Aufruf kam von einer unbekannten IP-Adresse. Das ist verdächtig, aber immer noch nur halbwegs krank.
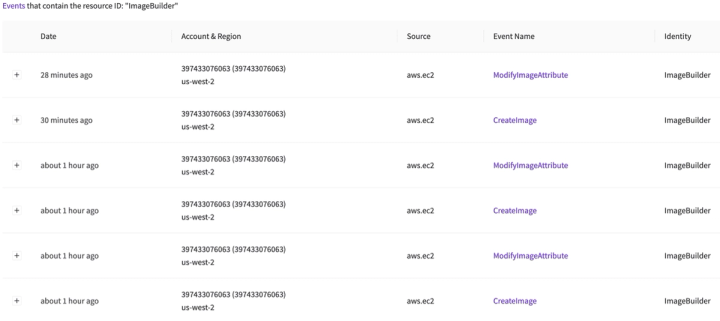
- Es ist das erste Mal, dass ich diese IP-Adresse bei diesem IAM-Benutzer sehe, und der Benutzer zeigt frühere Aktivitäten, die zu einem Batch-Prozess passen. Gut, jetzt tendiere ich zu krank. Normalerweise sehen wir bei solchen Jobs keine wechselnden IP-Adressen; das riecht nach abhandengekommenen Zugangsdaten:
- Dieser IAM-Benutzer kann diese Aktionen weiterhin ausführen. Solange mir niemand sagt, dass das beabsichtigt war, nenne ich das krank und werde Blutung stoppen und diesem Benutzerkonto eine IAM-Beschränkung auferlegen (vermutlich eine Deny-All-Richtlinie, es sei denn, es handelt sich um einen kritischen Prozess – dann würde ich eine IP-Beschränkung verwenden).
Zusammengefasst:
- Ich habe ein AMI gefunden, das an ein unbekanntes Konto freigegeben wurde: krank
- Dieses AMI gehörte zu einem Produktions-Asset: Krank und Blutung stoppen
- Die Aktion stammte von einem IAM-Benutzer mit weitreichenden Berechtigungen zum Erstellen und Freigeben von AMIs, aber sonst nichts: Vielleicht krank, Untersuchung läuft.
- Der IAM-Benutzer hat dieses AMI von einer unbekannten, neuen IP-Adresse aus erstellt: Krank, die (restliche) Blutung stoppen.
- Es gibt keine weitere erkannte Aktivität von der IP-Adresse: Wahrscheinlich eingedämmt und nicht mehr Sick
- Ich weiß immer noch nicht, wie diese Anmeldedaten abgeflossen sind: Sick, und es ist an der Zeit, unsere klassischen IR-Kollegen hinzuzuziehen, um zu klären, ob es sich um eine Kompromittierung des Netzwerks oder eines Hosts handelt.
Ich bin dies rasch durchgegangen, um zu verdeutlichen, wie ich solche Vorfälle bewerte. Mit nur wenigen Unterschieden wäre derselbe Befund völlig normal gewesen. Stellen Sie sich vor, wir hätten festgestellt, dass es mit einem neuen Konto geteilt wurde, das wir kontrollieren, das aber noch nicht registriert war. Oder das AMI war für eine Entwicklungsinstanz bestimmt, die keine sensiblen Daten enthält. Oder die API-Aufrufe kamen aus unserem Netzwerk, zur erwarteten Zeit, oder vom System eines Administrators, der es absichtlich geteilt hat. Dieses Beispiel ist nicht gravierend, aber es ist eine bekannte Form der Datenexfiltration, die von aktiven Bedrohungsakteuren genutzt wird. Sobald ich eine neue Information finde, bewerte ich, ob sie Sick oder Not Sick ist und ob ich Stop the Bleed anwenden muss.
Worin unterscheidet sich das in der Cloud? Weil mehr auf dem Spiel steht, wenn potenziell alles mit dem Internet verbunden ist. Wir müssen schneller denken und handeln, und ich finde diese Merkhilfe hilfreich, um auf Kurs zu bleiben.