Entenda o risco das políticas. Faça perguntas sobre políticas em linguagem natural. Solicite uma demonstração →
Published:
Conter credenciais EC2 comprometidas sem (esperemos) quebrar nada
by FireMon
Existem várias técnicas para conter credenciais de instância comprometidas. As mais fáceis são as que têm maior probabilidade de quebrar algo, mas há opções criativas para bloquear os atacantes sem interromper as aplicações.
Nos últimos anos, assistimos a alguns avanços importantes da Amazon no sentido de reduzir os riscos de um atacante roubar e utilizar indevidamente as credenciais atribuídas a instâncias da AWS. Certo, boa parte disso aconteceu depois daquela violação enorme de que todos ainda falam, mas agora dispomos de ferramentas muito melhores para prevenir este tipo de ataque. Dito isto, continua a ser muito comum e a figurar no topo da lista de ameaças à cloud de toda a gente.
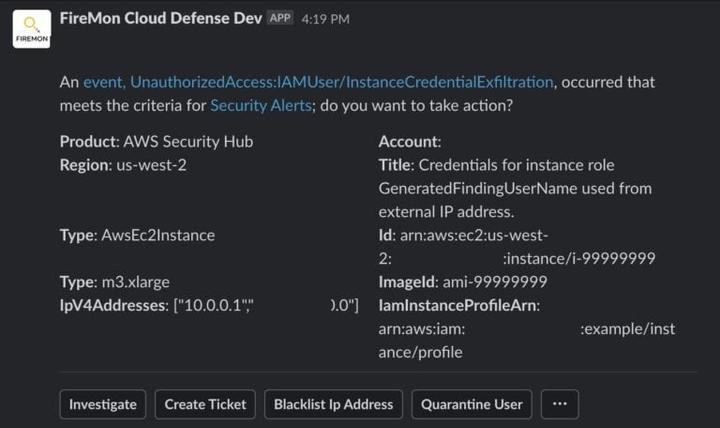
No mês passado, a AWS lançou algumas novas opções de política para restringir as credenciais de instância, o que deu origem à ideia para este artigo. Isso e uma descoberta interessante feita na comunidade de segurança na cloud, de que falarei daqui a pouco. Por muito boa que seja esta nova capacidade, combinada com a melhoria drástica das deteções de exfiltração de credenciais do GuardDuty da AWS, a certa altura poderá receber um alerta de uma ferramenta como a nossa e ter de acionar o seu processo de resposta a incidentes:
Ao longo dos anos, reuni e testei um conjunto de opções de contenção, para a maioria das quais tenho laboratórios na formação de resposta a incidentes na cloud que preparei com Will Bengtson. Há uma quantidade surpreendente de nuances para garantir que consegue conter o atacante sem quebrar nada. Ao trabalhar com credenciais de instância, está na prática a interagir com três componentes: o serviço IAM, que gere as permissões; o Instance Metadata Service (IMDS), que trata de passar essas credenciais à instância; e o código/SDK que executa a sua aplicação dentro da instância e que utiliza as credenciais. Note que estou deliberadamente a simplificar algumas coisas e a ignorar as Service Control Policies e as políticas de recursos (buckets). (Todas as capturas de ecrã deste artigo foram descaradamente roubadas da minha própria formação, por isso, não me denuncie às autoridades.)
E um breve enquadramento para quem não sabe: quando atribui uma função IAM a uma instância, essa instância recebe credenciais com rotação automática que lhe conferem as permissões dessa função. Mas se um atacante conseguir aceder à instância de alguma forma, por exemplo através de um ataque SSRF ou de força bruta a SSH, pode copiar essas credenciais e utilizá-las fora da AWS ou a partir de uma conta AWS sob o seu controlo.
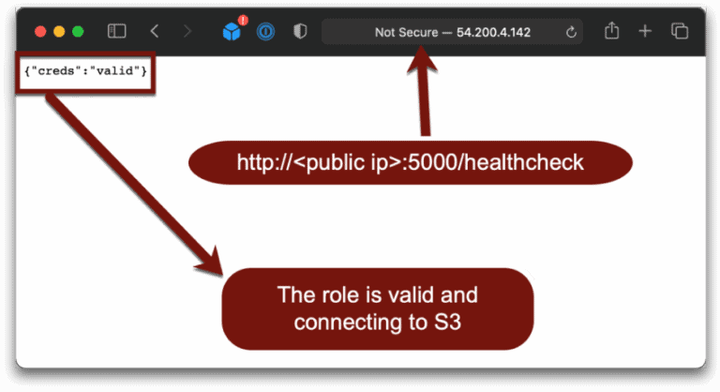
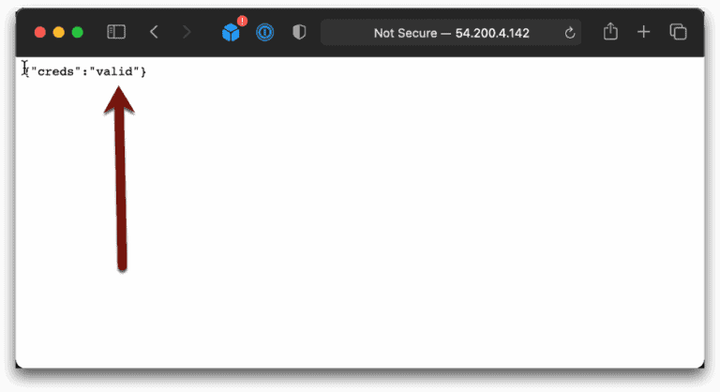
Como preparação, o Will escreveu uma pequena aplicação que tenta estabelecer uma ligação interna a um bucket S3 e reporta se as credenciais são válidas (não, os endereços IP apresentados já não são válidos):
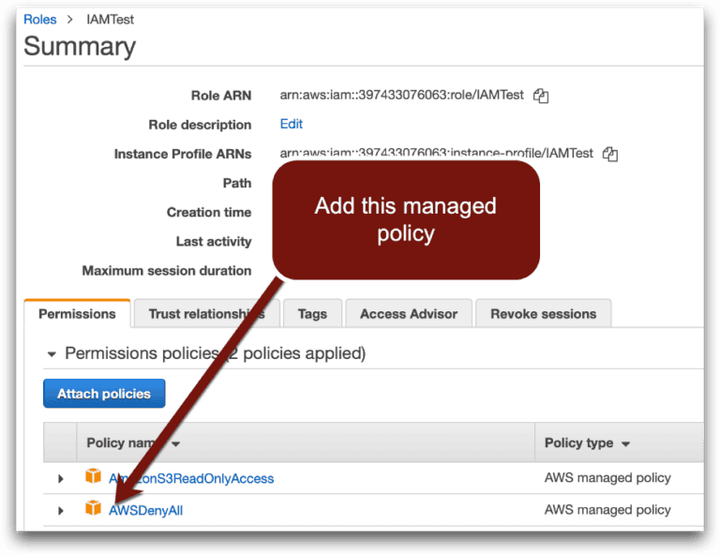
Opção 1: adicionar uma política Deny All à função
Esta é, de longe, a mais fácil e rápida. Ao adicionar uma política Deny All à função IAM, todas as chamadas à API falham e o atacante não consegue causar mais danos.
É rápido, fácil e uma forma muito expedita de quebrar a sua aplicação, uma vez que isto impede quaisquer chamadas à API legítimas:
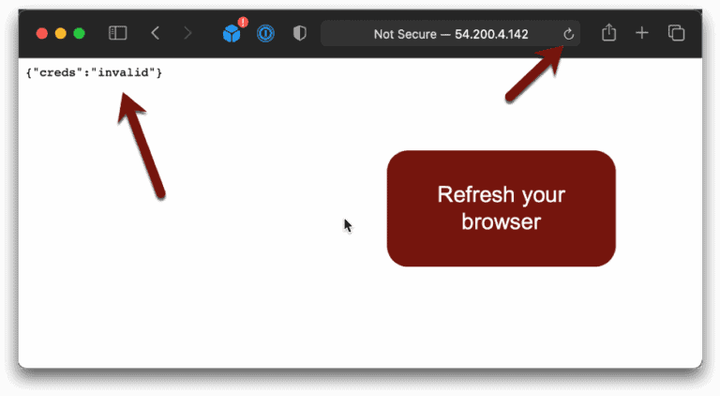
Recorde-se: o nosso objetivo é manter o atacante afastado sem quebrar as nossas aplicações legítimas em execução.
Ups.
Opção 2: revogar a sessão
A AWS tem uma funcionalidade interessante para revogar sessões ativas. Com um clique num botão da consola, é possível adicionar uma política Deny All personalizada que apenas nega o acesso a sessões iniciadas antes do momento definido no clique (não existe uma chamada à API simples para isto, mas não é difícil escrever a sua própria política para fazer o mesmo).
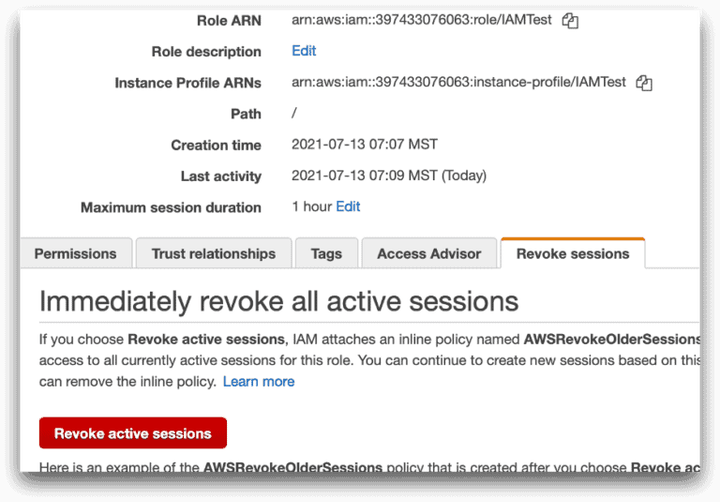
Partindo do princípio de que impediu o atacante de comprometer a nova sessão, em teoria isto bloqueá-lo-ia ao expirar as credenciais roubadas e permitiria que a sua aplicação funcionasse com credenciais novas. Mas…
Não. Ups número 2. Porquê?
O IMDS só atualiza as credenciais quando estas expiram. O IMDS é um serviço distinto do IAM e não sabe que revogou as credenciais, nem tem qualquer razão, ou motivação, para obter as novas credenciais e fornecê-las à instância. Continuará a servir as credenciais revogadas até ao fim da sessão.
Opção 3: alterar a função IAM e negar a função antiga
Agora começamos a sofisticar. E se criarmos uma nova função, alterarmos a instância para utilizar a nova e bloquearmos a antiga? Tal como antes, isto só funciona se souber que o atacante não consegue simplesmente roubar as credenciais da nova função.
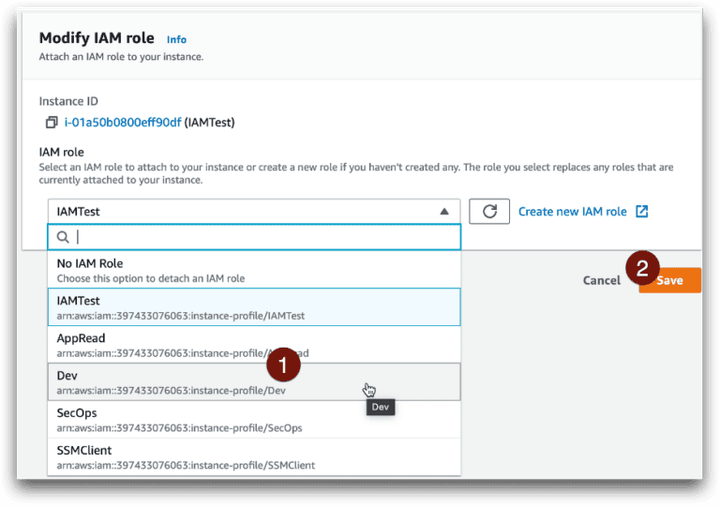
Não. Ups número 3. Então, o que se passa aqui?
A maior parte do código e dos SDKs estabelece uma sessão IAM no arranque e obtém as credenciais a partir do serviço de metadados. Estas credenciais têm uma duração de sessão, semelhante a um Time to Live (TTL). As credenciais são mantidas em memória e utilizadas até perto do fim dessa duração. Por exemplo, ao utilizar a biblioteca Boto em Python (que usámos nesta demonstração), o código só procura novas credenciais 15 minutos antes da expiração das credenciais.
Assim, a aplicação continuará a falhar até procurar credenciais atualizadas. Consoante a configuração, o valor predefinido tende a ser de 6 em 6 horas numa instância EC2. Certo, talvez tenha programadores excelentes, com um tratamento de erros impecável, que tentem obter novas credenciais após uma chamada à API falhada, mas isso é pouco provável, já que não é um caso de uso comum.
O código na instância continua a tentar utilizar a função antiga porque não sabe fazer de outra forma. Na opção 2, quebrámos as coisas porque o IMDS não sabia que devia consultar o IAM para atualizar as credenciais. Desta vez, o código não sabe que deve comunicar com o IMDS para obter novas credenciais.
Opção 4: inserir um VPC endpoint
Esta fui eu a sofisticar e é, de longe, a mais complicada, mas funciona muito bem. Todas as instâncias residem numa VPC (Virtual Private Cloud), que é a sua rede virtual na AWS. Normalmente, todas as chamadas à API saem pela Internet para chegar aos endpoints públicos da AWS. Na verdade, se tiver uma instância numa sub-rede privada sem rota de saída para a Internet, essas chamadas à API vão falhar.
Ora, isso é um problema considerável se quiser que a sua instância privada comunique com o seu próprio bucket S3 privado. Antes tínhamos de ativar o acesso à Internet, o que tem custos e expõe as coisas de formas que nós, profissionais de segurança, gostamos de minimizar.
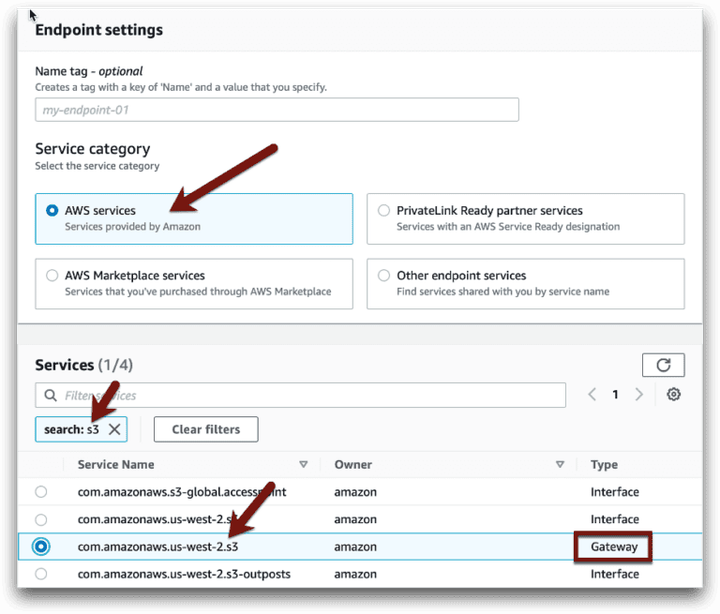
A resposta da Amazon designa-se Service Endpoint. Trata-se de estruturas de encaminhamento internas, definidas por software, que pode configurar para permitir que recursos numa VPC comuniquem com endpoints de API (e outras coisas, mas este não é o artigo para aprofundar isso), tudo na rede interna da Amazon. O interessante é que, ao utilizar um VPC endpoint, a AWS insere contexto adicional no tráfego de rede, uma vez que pode agora incorporar dados nos seus cabeçalhos privados, e podemos usar isso como condições nas nossas políticas IAM!
Primeiro, adicionamos um VPC endpoint para o S3 à sub-rede onde se encontra a nossa instância:
Em seguida, adicionamos à nossa política IAM uma condição que nega todo o tráfego que não provenha da VPC esperada. É assim que o fazemos no laboratório de formação:
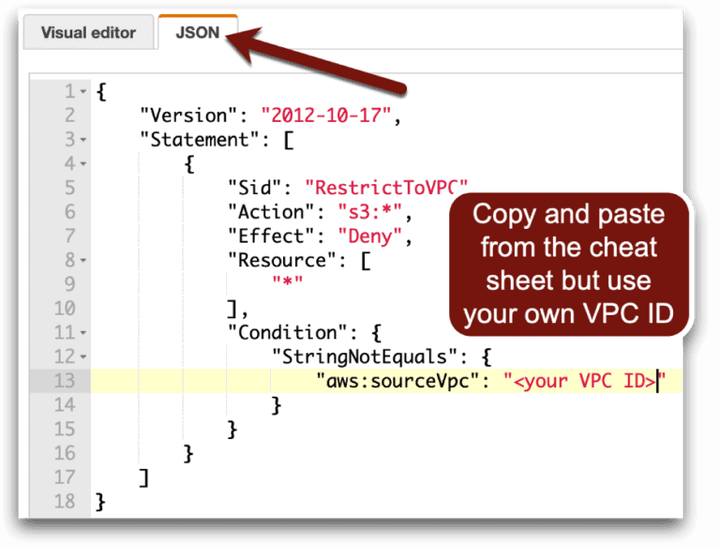
Se isto funcionar, as chamadas à API a partir da nossa instância continuarão a funcionar, mas as credenciais falharão se forem utilizadas a partir de qualquer lugar fora desta VPC (esperemos, portanto, que o atacante não tenha acesso a outro recurso na VPC).
Boa! As nossas credenciais só funcionam a partir do interior da VPC e o atacante fica bloqueado. É EXATAMENTE assim que funciona aquela Service Control Policy que referi acima. O problema da SCP é que os service endpoints acrescentam custo e complexidade, e ativar essa política sem ter todos os endpoints corretos implementados vai quebrar coisas, mas agora à escala empresarial.
Um comportamento inesperado
Como referi, criámos este laboratório há cerca de 2 anos e já passaram por ele algumas centenas de formandos. Na semana passada, Andre Rall, da Uptycs , publicou o seguinte numa comunidade de segurança na cloud em que ambos participamos (utilizado com autorização):
Alguém sabe se isto deveria acontecer? Tenho uma função associada a um instance profile que está associado a uma instância. Quando removo a função do instance profile (via CLI), mas mantenho o instance profile associado à instância, a instância continua a conseguir utilizar as credenciais da função. O meu raciocínio diz-me que, como a função não está associada, a instância não deveria poder continuar a utilizá-la, mas talvez me esteja a escapar alguma coisa.
Acontece que voltamos a deparar-nos com aquela interação entre serviços. Nos bastidores, um instance profile é o que a AWS utiliza para ligar uma função a uma instância no serviço de metadados. O Andre removeu a função do instance profile, mas a função continua a existir e o instance profile também.
Seria de esperar que o IMDS deixasse de conseguir servir as credenciais, mas ele continua a TER as credenciais e não sabe o que aconteceu no serviço IAM. Continua a servir as credenciais e a função continua a permiti-las, pelo que continuam a funcionar. Revogar as credenciais FUNCIONARIA neste caso, porque o IMDS não conseguiria obter as novas credenciais depois de o instance profile e a função serem desassociados.
Conter credenciais IAM envolve muitas nuances, e este é apenas um conjunto de exemplos de um serviço (EC2). Mas assim que perceber o fluxo entre o serviço IAM, o IMDS e os SDKs, ficará com uma base sólida em alguns dos princípios fundamentais que pode aplicar noutras situações.
E não se esqueça de conhecer o nível gratuito do FireMon Cloud Defense que acabámos de lançar.