Entenda o risco das políticas. Faça perguntas sobre políticas em linguagem natural. Solicite uma demonstração →
Published:
As 2 principais dicas de um paramédico para a resposta a incidentes na cloud
by Rich Mogull
Uma das vantagens de ter muitos passatempos diferentes é que eles moldam o cérebro de uma forma um pouco distinta. O leitor acaba por abordar os problemas de outro ângulo, à medida que cruza mentalmente domínios diferentes. Como paramédico semiativo, encontro imensos paralelos entre responder a emergências de carne e osso e gerir emergências de bits e bytes.
Nos últimos anos tenho dado muita formação sobre resposta a incidentes na cloud e comecei a usar duas expressões do mundo dos paramédicos que parecem ressoar bem junto de quem está a dar os primeiros passos na resposta a incidentes. Estes auxiliares de memória ajudam bastante a afinar o foco e a otimizar o processo. Ainda que se apliquem a qualquer resposta a incidentes, considero que desempenham um papel maior no lado da cloud, devido às diferenças inerentes causadas sobretudo pela existência do plano de gestão.
Grave ou não grave
Os paramédicos conseguem fazer muito em comparação com uma pessoa comum, mas somos bastante limitados no domínio da medicina. Somos extremamente bem treinados para reconhecer rapidamente ameaças à vida e à integridade física, sejam elas médicas ou traumáticas, e para estabilizar e transportar os doentes até aos cuidados definitivos. Uma frase-chave que nos é martelada é “grave ou não grave”. É um auxiliar de memória que nos ajuda a lembrar de nos concentrarmos no quadro geral e de perceber se o doente está em apuros sérios.
Adoro usar esta expressão para ajudar os profissionais de segurança da informação a avaliar a gravidade de um incidente. Na cloud, ensinamo-los a identificar constatações significativas que exigem concentração imediata no problema antes de avançar. No socorro pré-hospitalar, chama-se a isso uma “ameaça à vida”. Uma vez que a resposta a incidentes na cloud aproveita competências de IR já existentes com uma nova tecnologia subjacente, essa frase é apenas um lembrete para considerar as consequências de uma constatação que normalmente não desencadearia os instintos de quem responde. Eis alguns exemplos simples:
- Dados tornados públicos em armazenamento de objetos (S3) que não deveriam estar.
- Uma entidade IAM potencialmente comprometida com privilégios de administrador ou outros privilégios elevados.
- Várias chamadas de API bem-sucedidas utilizando diferentes utilizadores IAM a partir do mesmo endereço IP desconhecido.
- Partilha entre contas de uma imagem ou snapshot com uma conta desconhecida.
- Uma instância/VM potencialmente comprometida que tem privilégios IAM.
Quando as escrevo, a maioria dos profissionais de resposta diz “claro, isso é óbvio”, mas, pela minha experiência, os responsáveis tradicionais precisam de algum tempo para reconhecer estas questões e perceber que são muito mais críticas do que a máquina virtual comprometida comum.
“Grave ou não grave” na cloud traduz-se quase sempre por “está público ou passaram para o plano de gestão (IAM)”.
Grave ou não grave. Sempre que encontrar uma nova prova, uma nova peça do puzzle, passe isto pela cabeça para perceber se o doente está prestes a colapsar ou se apenas está constipado.
Estancar a hemorragia
Muitos de vós já terão frequentado um curso de suporte básico de vida e primeiros socorros. Provavelmente aprenderam o “ABC”: vias aéreas (Airway), respiração (Breathing) e circulação (Circulation).
Pois bem, afinal estragámos mesmo essa.
A investigação começou a mostrar que, numa emergência, as pessoas se concentravam no ABC excluindo o quadro geral. Até paramédicos eram apanhados a fazer reanimação cardiopulmonar em alguém que estava a esvair-se em sangue por uma ferida na perna. Por vezes era uma reanimação perfeita. Percebia-se pela rapidez com que o doente ficava sem sangue. Hoje em dia acrescentamos “tratar a ameaça à vida” no início, e “estancar a hemorragia” é a prioridade máxima.
Percebe onde quero chegar?
Em todas as formações que dei, encontro profissionais de resposta muito experientes concentrados na sua análise e investigação enquanto a cloud se esvai em sangue à frente deles. Porquê?
Porque não estão habituados a que tudo esteja (potencialmente) na Internet. Todo o plano de gestão está na Internet, pelo que, se um atacante obtiver credenciais, não é possível travá-lo com uma firewall nem desligando o acesso a um servidor. Se algo está comprometido e exposto, está comprometido e exposto a… bem, potencialmente toda a gente, em todo o lado, ao mesmo tempo.
Estancar a hemorragia anda de mãos dadas com grave ou não grave. Se encontrar algo grave, é necessário contê-lo ali mesmo antes de avançar? É um equilíbrio delicado, porque, se a decisão for errada, poderá estar a desperdiçar tempo precioso enquanto o atacante continua a progredir. Estancar a hemorragia equivale a “isto é tão mau que tenho de resolver já”. Mas, assim que estancar a hemorragia, tem de voltar imediatamente ao ponto onde estava e continuar o processo de análise e resposta, pois pode ainda estar a acontecer muita coisa má.
A minha lista curta?
- Qualquer entidade IAM com privilégios elevados que aparente estar comprometida.
- Dados sensíveis que estejam, de alguma forma, públicos.
- Partilha entre contas/subscrições/projetos ou acesso a um destino desconhecido.
Há mais, mas essa é a lista curta. Cada um destes casos indica perda de dados ou comprometimento em curso e é necessário contê-los de imediato.
Ver a coisa em ação
Eis um exemplo. As capturas de ecrã são uma mistura de Slack, da consola AWS e do FireMon Cloud Defense. É a minha cadeia de ferramentas, e isto funcionará com aquilo que tiver. Nas formações usamos também consultas Athena para simular um SIEM, mas quero manter este artigo curto (mais ou menos).
Comecemos com um alerta de gravidade média no Slack, proveniente da nossa plataforma combinada de CSPM/CDR:
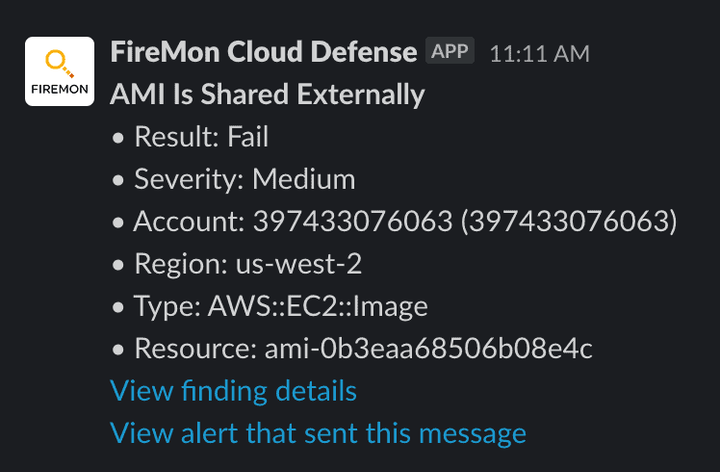
Grave ou não grave? Ainda não sabemos. Isto pode ser totalmente legítimo. Muito bem, altura de investigar. Vou mostrar isto tanto na plataforma como na consola AWS. O meu primeiro passo é ver o que está partilhado e onde. Como o alerta tem o ID da AMI, podemos ir diretamente até lá:
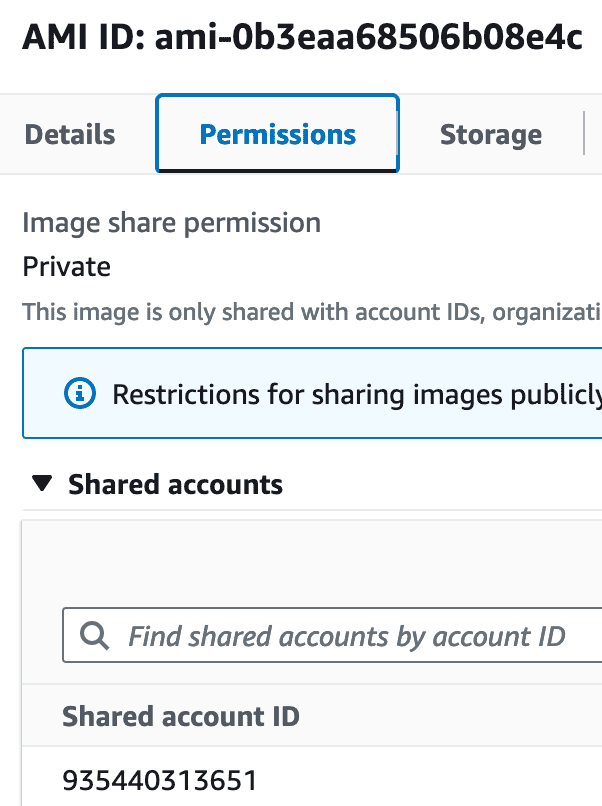
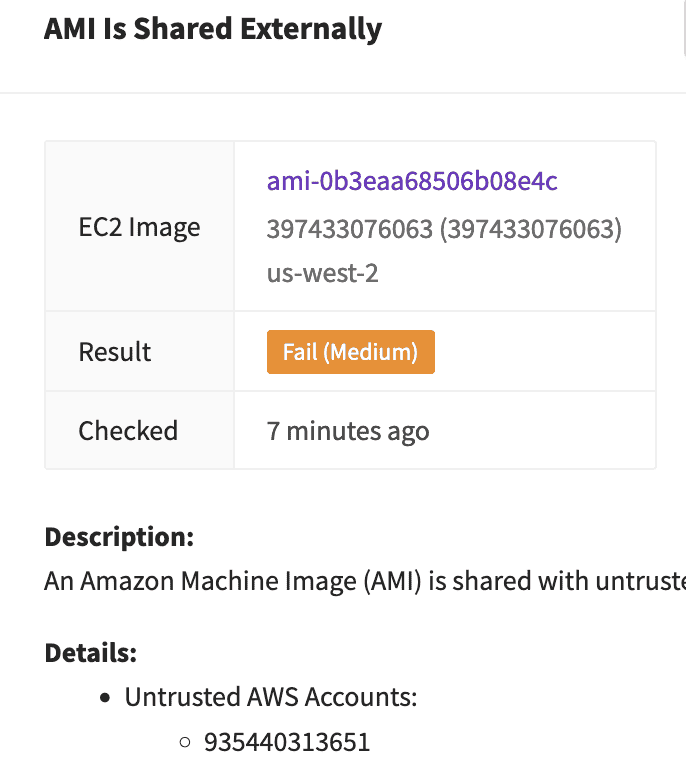
Muito bem - consigo ver que está partilhada com outra conta. Será uma conta minha? Que eu conheça? A minha ferramenta assinala-a como não fidedigna, uma vez que não é uma conta registada no sistema, mas na vida real eu iria querer consultar a lista principal de contas da organização, só para confirmar.
Então, grave ou não grave? Na minha cabeça, continua a ser um talvez. Tenho uma imagem partilhada com uma conta potencialmente não fidedigna. Mas ainda não sei o que está partilhado. Tenho de rastrear isso até à instância de origem. Não me vou dar ao trabalho de fazer uma análise forense completa; vou apoiar-me em informação contextual, já que preciso de perceber isto muito depressa. Neste caso, tivemos sorte:
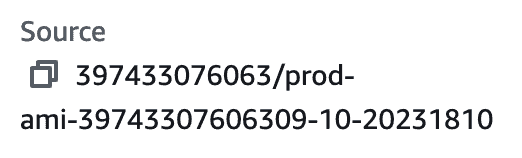
Tem "Prod" no nome, portanto… classifico isto como “provavelmente grave”. Estancar a hemorragia? Na vida real, tentaria primeiro contactar quem fosse proprietário daquela conta AWS, mas, por hoje, considero que tenho informação suficiente para colocar a AMI em quarentena. Eis como fazê-lo na consola e no Cloud Defense:
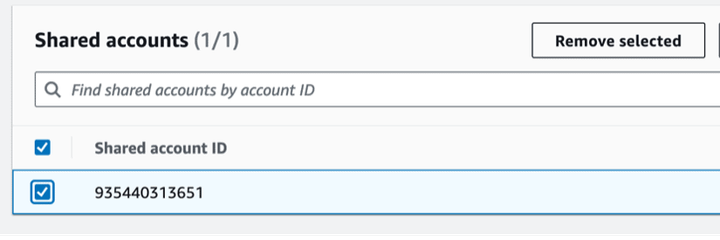
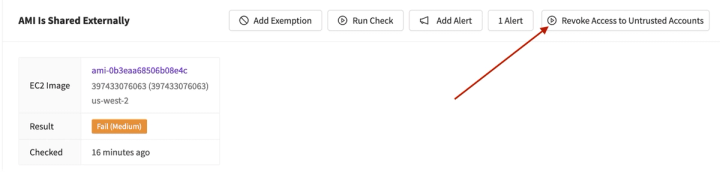
Muito bem, estancámos a hemorragia? Estancámos… parte da hemorragia. Bloqueámos a AMI, mas continuamos sem saber como é que ela foi lá parar. Também não sabemos quem é o proprietário daquela conta AWS. Podemos descobrir? Não. Se não é nossa, tudo o que podemos fazer é reportá-la à AWS e deixar que tratem do resto.
Vamos caçar as chamadas de API para descobrir quem a partilhou e o que mais fez. Vou fazer estas partes seguintes na plataforma, mas o leitor executaria consultas no seu SIEM ou no Athena para encontrar a mesma informação. Farei artigos futuros sobre todas as consultas, mas este artigo centra-se nos conceitos de gravidade/hemorragia.
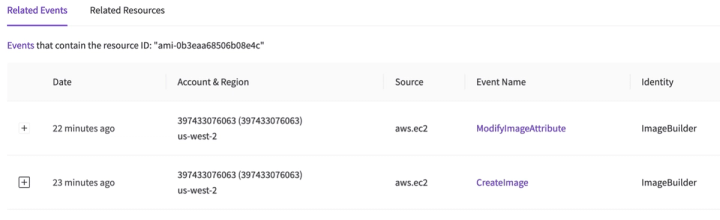
Muito bem - vejo que uma entidade IAM chamada ImageBuilder é a responsável. Mais uma vez, como este artigo já vai longo, verifiquei algumas coisas e eis o que aprendi:
- ImageBuilder é um utilizador IAM com privilégios para criar imagens e modificar os seus atributos, mas nada mais. No entanto, a política não tem restrições de recursos, pelo que pode criar uma imagem de qualquer instância. E não tem restrições condicionais, pelo que pode partilhar com qualquer conta. Este é um raio de impacto moderado a baixo - tem privilégios a mais, mas não de forma terrível. Chamo-lhe mais ou menos grave.
- A chamada de API veio de um endereço IP desconhecido. Isto é suspeito, mas ainda assim apenas mais ou menos grave.
- É a primeira vez que vejo aquele endereço IP a ser utilizado por este utilizador IAM, e o utilizador apresenta atividade anterior alinhada com um processo em lote. Muito bem, agora inclino-me para grave. Normalmente não vemos endereços IP rotativos em tarefas deste tipo; cheira-me a credencial perdida:
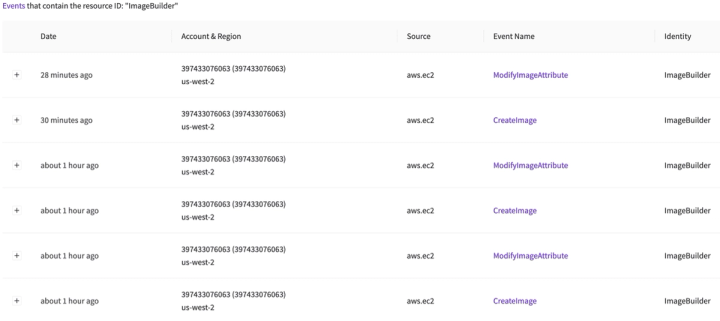
- Aquele utilizador IAM pode continuar a executar estas ações. A menos que alguém me diga que isto foi intencional, classifico-o como Grave e vou Estancar a hemorragia e impor uma restrição IAM a essa conta de utilizador (provavelmente uma política Deny All, a não ser que se trate de um processo crítico, caso em que usaria uma restrição por IP).
Em resumo:
- Encontrei uma AMI partilhada com uma conta desconhecida: Grave
- Aquela AMI era de um ativo de produção: Grave e estancar a hemorragia
- A ação partiu de um utilizador IAM com privilégios amplos para criar AMIs e partilhá-las, mas nada mais: Talvez grave, ainda em investigação.
- O utilizador IAM criou aquela AMI a partir de um endereço IP novo e desconhecido: Grave, estancar (o resto da) hemorragia.
- Não há nenhuma outra atividade detetada a partir do endereço IP: provavelmente contido e já não está Doente
- Continuo sem saber como essas credenciais foram divulgadas: Doente, e é altura de chamar os nossos colegas de resposta a incidentes tradicional para verificar se houve um comprometimento da rede ou do host.
Percorri isto rapidamente para evidenciar como penso sobre estas questões. Com apenas algumas diferenças, esta mesma deteção teria sido totalmente normal. Imagine que percebíamos que tinha sido partilhada com uma nova conta que controlamos, mas que ainda não estava registada. Ou que a AMI era para uma instância de desenvolvimento que não contém nada sensível. Ou que as chamadas à API vinham da nossa rede, à hora esperada, ou do sistema de um administrador que pretendia mesmo partilhá-la. Este exemplo não é gritante, mas é uma forma conhecida de exfiltração de dados utilizada por agentes de ameaça ativos. À medida que encontro cada informação, avalio se é Doente ou Não Doente e se preciso de Estancar a Hemorragia.
Em que é que isto é diferente na cloud? Porque o risco é maior quando tudo pode estar exposto à Internet. Temos de pensar e agir mais depressa, e considero que este auxiliar de memória ajuda a manter-nos no rumo certo.