Comprendete il rischio delle policy. Ponete domande sulle policy in linguaggio naturale. Richiedi una demo →
Published:
Contenere le credenziali EC2 compromesse senza (si spera) creare disservizi
by FireMon
Esistono diverse tecniche per contenere le credenziali di istanza compromesse. Le più semplici sono anche quelle che rischiano maggiormente di causare disservizi, ma esistono opzioni creative per escludere gli attaccanti senza compromettere le applicazioni.
Negli ultimi anni abbiamo visto Amazon compiere progressi importanti per ridurre il rischio che un attaccante rubi e abusi delle credenziali assegnate alle istanze AWS. Certo, gran parte di questo è avvenuto dopo quella violazione enorme di cui tutti parlano ancora, ma oggi disponiamo di strumenti molto migliori per prevenire questo tipo di attacco. Detto questo, resta molto diffuso e occupa una posizione elevata nell'elenco delle minacce cloud di chiunque.
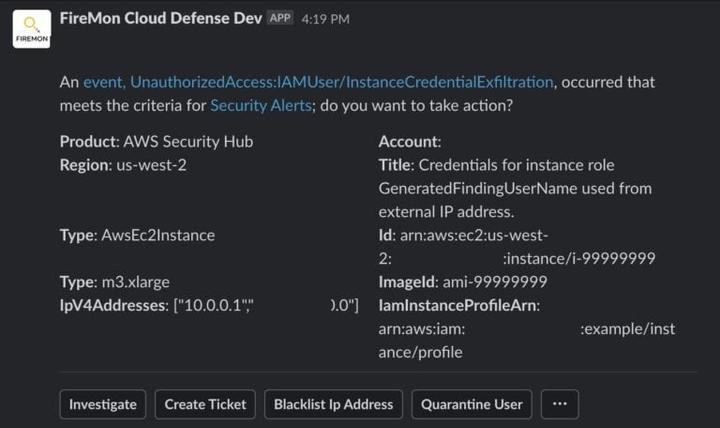
Il mese scorso AWS ha rilasciato alcune nuove opzioni di policy per blindare le credenziali di istanza, ed è da qui che è nata l'idea per questo articolo. Da qui e da un'interessante scoperta emersa dalla community della sicurezza cloud, di cui parlerò tra poco. Per quanto questa nuova funzionalità sia ottima, unita al netto miglioramento delle rilevazioni GuardDuty di AWS per l'esfiltrazione di credenziali, prima o poi potrebbe arrivarle un alert da uno strumento come il nostro e dovrà avviare il suo processo di incident response:
Negli anni ho raccolto e testato una serie di opzioni di contenimento, per la maggior parte delle quali ho creato laboratori nel corso di formazione sull'incident response nel cloud che ho realizzato con Will Bengtson. C'è una quantità sorprendente di sfumature nel riuscire a contenere l'attaccante senza causare disservizi. Quando si lavora con le credenziali di istanza si interagisce di fatto con tre componenti: il servizio IAM che gestisce i permessi, l'Instance Metadata Service (IMDS) che si occupa di trasmettere tali credenziali all'istanza e il codice/SDK che esegue l'applicazione all'interno dell'istanza utilizzando le credenziali. Si noti che sto deliberatamente semplificando alcuni aspetti e che non considero le Service Control Policy e le policy di risorsa (bucket). (Tutti gli screenshot di questo articolo sono spudoratamente presi dalla mia formazione, quindi la prego di non segnalarmi alle autorità.)
E un rapido richiamo per chi non lo sapesse: quando si assegna un ruolo IAM a un'istanza, a quell'istanza vengono fornite credenziali a rotazione automatica che le conferiscono i permessi di quel ruolo. Ma se un attaccante riesce ad accedere all'istanza in qualche modo, ad esempio tramite un attacco SSRF o forzando SSH, può copiare quelle credenziali e utilizzarle al di fuori di AWS o da un account AWS sotto il suo controllo.
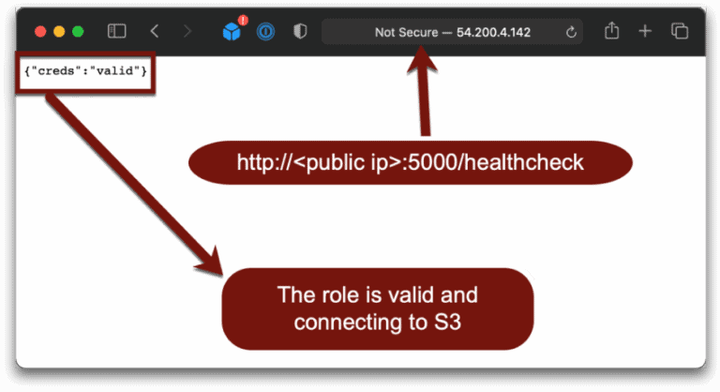
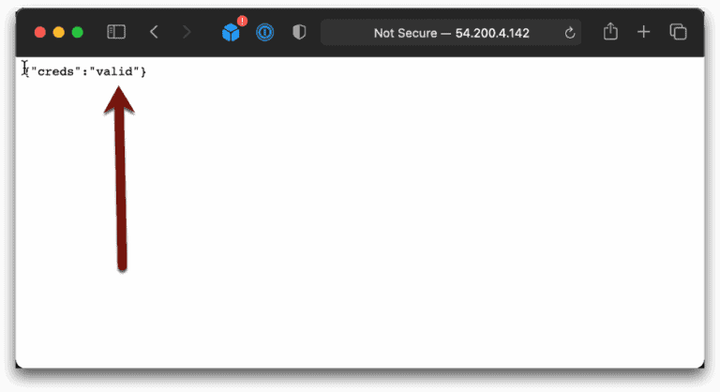
Come preparazione, Will ha scritto una piccola applicazione che prova a stabilire una connessione interna a un bucket S3 e segnala se le credenziali sono valide (no, gli indirizzi IP mostrati non sono più validi):
Opzione 1: aggiungere una policy Deny All al ruolo
Questa è di gran lunga la soluzione più semplice e rapida. Aggiungendo una policy Deny All al ruolo IAM, tutte le chiamate API falliranno e l'attaccante non potrà causare ulteriori danni.
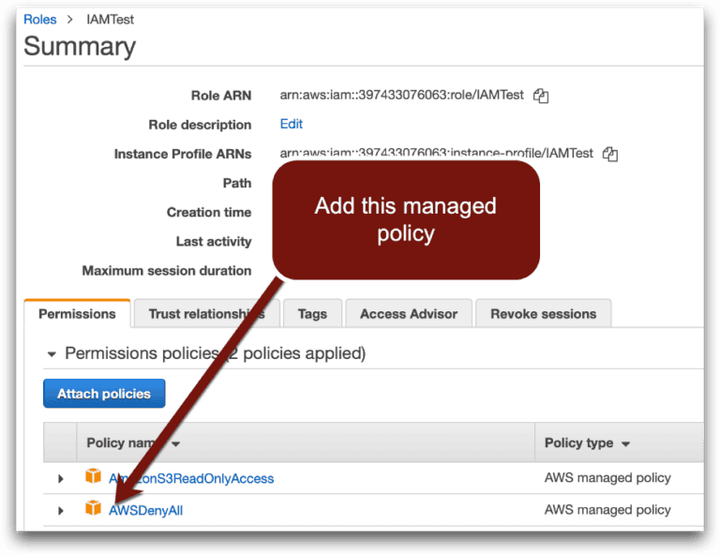
È veloce, semplice e un modo davvero rapido per mandare in crash la sua applicazione, perché bloccherà anche tutte le chiamate API legittime:
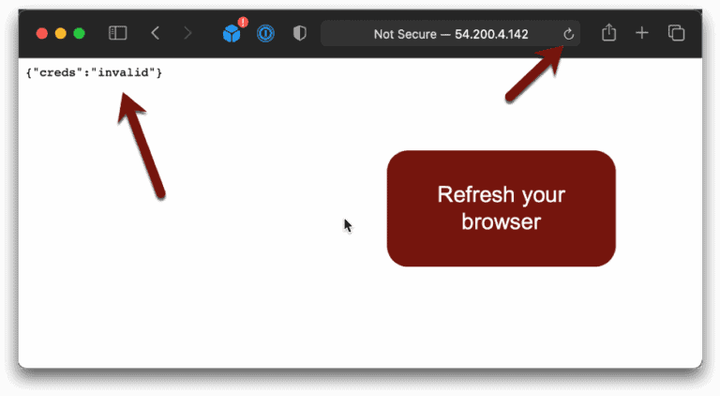
Ricordi: il nostro obiettivo è tenere fuori l'attaccante senza interrompere le applicazioni legittime in esecuzione.
Ops.
Opzione 2: revocare la sessione
AWS offre una funzionalità interessante per revocare le sessioni attive. Con un clic nella console è possibile aggiungere una policy Deny All personalizzata che nega l'accesso solo alle sessioni avviate prima dell'orario impostato al momento del clic (non esiste una semplice chiamata API per questo, ma non è difficile scrivere una policy che faccia lo stesso).
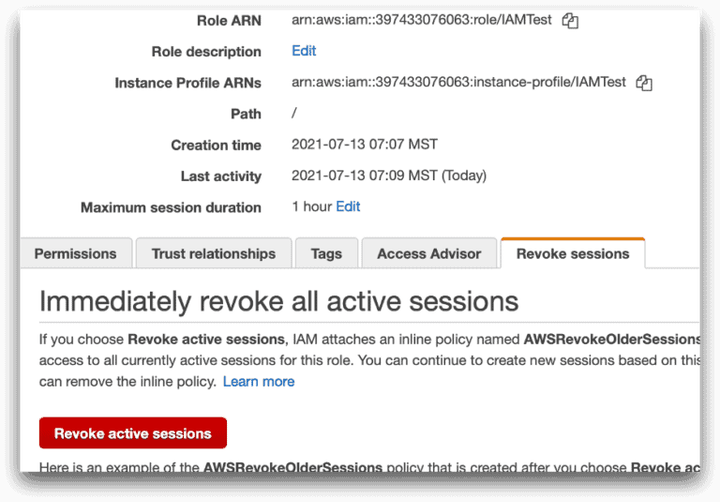
Ora, supponendo di aver impedito all'attaccante di compromettere la nuova sessione, in teoria questo lo escluderebbe facendo scadere le credenziali rubate e consentirebbe alla sua applicazione di funzionare con quelle nuove. Ma…
No. Ops numero 2. Perché?
L'IMDS aggiorna le credenziali solo quando scadono. IMDS è un servizio diverso da IAM e non sa che lei ha revocato le credenziali: non ha alcun motivo, né alcuna spinta, per recuperare le nuove credenziali e fornirle all'istanza. Continuerà a servire le credenziali revocate fino al termine della sessione.
Opzione 3: cambiare il ruolo IAM e negare il ruolo precedente
Ora iniziamo a fare le cose in modo più elaborato. E se creassimo un nuovo ruolo, facessimo passare l'istanza a quello nuovo e bloccassimo il precedente? Come prima, funzionerebbe solo se si ha la certezza che l'attaccante non possa rubare anche le credenziali del nuovo ruolo.
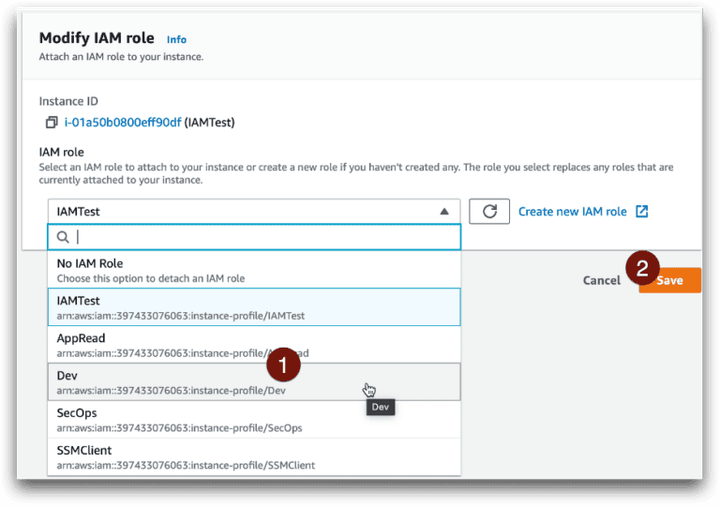
No. Ops numero 3. Quindi cosa sta succedendo?
La maggior parte del codice e degli SDK stabilisce una sessione IAM all'avvio e recupera le credenziali dal servizio di metadati. Queste credenziali hanno una durata di sessione, simile a un Time to Live (TTL). Le credenziali vengono mantenute in memoria e utilizzate fin quasi al termine della durata. Ad esempio, usando la libreria Boto in Python (come abbiamo fatto per questa demo), il codice non cercherà nuove credenziali fino a 15 minuti prima della loro scadenza.
Di conseguenza l'applicazione continuerà a fallire finché non cercherà credenziali aggiornate. A seconda della configurazione, il valore predefinito in un'istanza EC2 tende a essere ogni 6 ore. Certo, forse ha sviluppatori eccellenti con un'ottima gestione degli errori, capace di recuperare nuove credenziali dopo una chiamata API fallita, ma è improbabile perché non è un caso d'uso comune.
Il codice nell'istanza continua a usare il vecchio ruolo perché non sa fare altrimenti. Nell'opzione 2 abbiamo causato disservizi perché l'IMDS non sapeva di dover verificare con IAM per aggiornare le credenziali. Questa volta è il codice a non sapere di dover contattare l'IMDS per ottenere nuove credenziali.
Opzione 4: inserire un endpoint VPC
Questa è stata la mia trovata più elaborata ed è di gran lunga la più complessa, ma funziona molto bene. Tutte le istanze risiedono in un VPC (Virtual Private Cloud), che è la loro rete virtuale in AWS. Normalmente tutte le chiamate API escono su Internet per raggiungere gli endpoint pubblici di AWS. Di fatto, se ha un'istanza in una subnet privata senza una rotta in uscita verso Internet, quelle chiamate API falliranno.
Il che è piuttosto problematico se vuole che la sua istanza privata comunichi con il suo bucket S3 privato. In passato bisognava abilitare l'accesso a Internet, con i relativi costi e con un'esposizione che noi professionisti della sicurezza preferiamo ridurre al minimo.
La risposta di Amazon si chiama Service Endpoint. Si tratta di strutture di routing interne, software-defined, configurabili per consentire alle risorse in un VPC di comunicare con gli endpoint API (e altro ancora, ma non è questo l'articolo in cui approfondirlo) interamente sulla rete interna di Amazon. L'aspetto interessante è che, quando si utilizza un endpoint VPC, AWS inserisce del contesto aggiuntivo nel traffico di rete, dato che può incorporare dati nei propri header privati, e possiamo usarlo come condizione nelle nostre policy IAM.
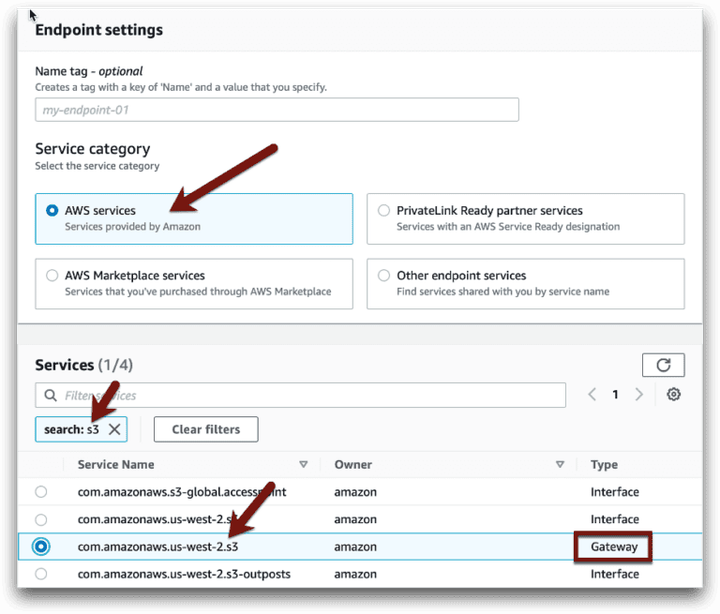
Per prima cosa aggiungiamo un endpoint VPC per S3 alla subnet in cui si trova la nostra istanza:
Poi aggiungiamo alla nostra policy IAM una condizione che nega tutto il traffico che non proviene dal VPC previsto. Ecco come lo facciamo nel laboratorio di formazione:
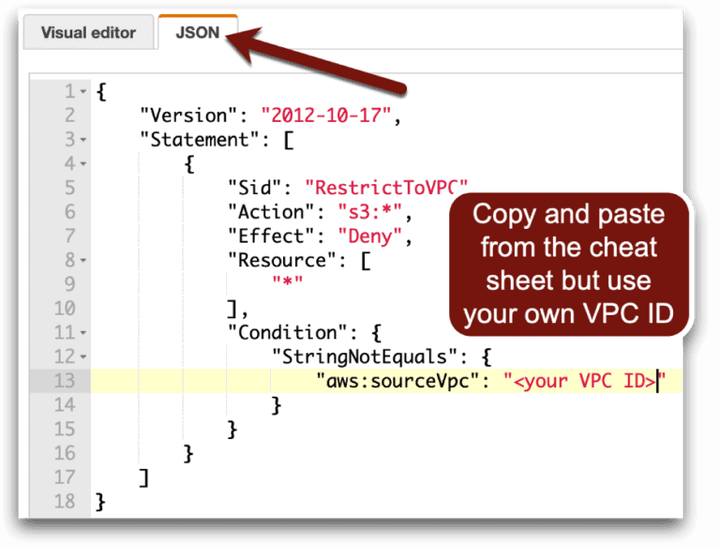
Se funziona, le chiamate API dalla nostra istanza continueranno a funzionare, mentre le credenziali falliranno se usate da qualsiasi luogo diverso da questo VPC (speriamo quindi che l'attaccante non abbia accesso a un'altra risorsa nel VPC).
Ottimo! Le nostre credenziali funzioneranno solo dall'interno del VPC e l'attaccante è escluso. È ESATTAMENTE così che funziona la Service Control Policy che ho menzionato sopra. Il problema con la SCP è che gli endpoint di servizio aggiungono costi e complessità, e attivare quella policy senza avere tutti gli endpoint necessari al loro posto causerà disservizi, questa volta però su scala aziendale.
Un comportamento inatteso
Come ho detto, abbiamo costruito questo laboratorio circa 2 anni fa e vi abbiamo fatto passare qualche centinaio di studenti. La settimana scorsa Andre Rall di Uptycs ha pubblicato quanto segue in una community di sicurezza cloud a cui partecipiamo entrambi (riportato con il suo permesso):
Qualcuno sa se questo comportamento è corretto? Ho un ruolo associato a un instance profile a sua volta associato a un'istanza. Quando rimuovo il ruolo dall'instance profile (via CLI) ma mantengo l'instance profile associato all'istanza, l'istanza è ancora in grado di usare le credenziali del ruolo. Il mio istinto mi dice che, poiché il ruolo non è più associato, l'istanza non dovrebbe poter continuare a usarlo, ma forse mi sfugge qualcosa.
Si scopre che ci imbattiamo di nuovo in quell'interazione tra servizi. Dietro le quinte, l'instance profile è ciò che AWS utilizza per collegare un ruolo a un'istanza nel servizio di metadati. Andre ha rimosso il ruolo dall'instance profile, ma il ruolo esiste ancora e anche l'instance profile esiste ancora.
Verrebbe da pensare che l'IMDS non sia più in grado di servire le credenziali, ma l'IMDS le HA ancora e non sa cosa sia successo nel servizio IAM. Continua a servirle e il ruolo continua ad autorizzarle, quindi funzionano ancora. In questo caso la revoca delle credenziali FUNZIONEREBBE, perché l'IMDS non sarebbe in grado di ottenere le nuove credenziali dopo il disaccoppiamento tra instance profile e ruolo.
Il contenimento delle credenziali IAM presenta molte sfumature, e questo è solo un insieme di esempi relativi a un unico servizio (EC2). Ma una volta compreso il flusso tra il servizio IAM, l'IMDS e gli SDK, avrà una base solida su alcuni principi fondamentali applicabili anche in altre situazioni.
E non dimentichi di dare un'occhiata al Free-Tier di FireMon Cloud Defense appena lanciato.