Comprendete il rischio delle policy. Ponete domande sulle policy in linguaggio naturale. Richiedi una demo →
Published:
I 2 consigli principali di un paramedico per l'incident response nel cloud
by Rich Mogull
Uno dei vantaggi di avere molti hobby diversi è che cablano il cervello in modo un po' differente. Ci si ritrova ad affrontare i problemi da un'angolazione diversa, mescolando mentalmente ambiti distinti. Come paramedico semi-attivo, trovo moltissimi parallelismi tra l'intervento sulle emergenze in carne e ossa e la gestione delle emergenze fatte di bit e byte.
Negli ultimi anni ho tenuto molti corsi sull'incident response nel cloud e ho iniziato a usare due espressioni del mondo dei paramedici che sembrano funzionare bene con chi si avvicina all'incident response. Questi aiuti mnemonici sono utili per affinare il focus e ottimizzare il processo. Pur essendo applicabili a qualsiasi incident response, ritengo che abbiano un ruolo più rilevante sul versante cloud, per via delle differenze intrinseche dovute soprattutto all'esistenza del management plane.
Grave o non grave
I paramedici possono fare molto rispetto a una persona qualsiasi, ma hanno possibilità piuttosto limitate in ambito medico. Siamo addestrati con grande cura a riconoscere rapidamente le minacce per la vita e per gli arti, siano esse mediche o traumatiche, e a stabilizzare e trasportare i pazienti verso le cure definitive. Una frase chiave che ci viene martellata in testa è "grave o non grave". È un aiuto mnemonico che ci ricorda di concentrarci sul quadro generale e di capire se il paziente è in seria difficoltà.
Amo usare questa espressione per aiutare i professionisti della sicurezza informatica a valutare la gravità di un incidente. Per il cloud, insegniamo loro a individuare le evidenze significative che impongono di concentrarsi su un problema immediatamente, prima di andare avanti. Nel soccorso sanitario si parla di "minaccia per la vita". Poiché l'incident response nel cloud applica competenze IR già esistenti a una nuova tecnologia sottostante, quella frase è semplicemente un promemoria per valutare le conseguenze di un'evidenza che normalmente potrebbe non attivare l'istinto di chi risponde. Ecco alcuni esempi semplici:
- Dati resi pubblici in un object storage (S3) che non dovrebbero esserlo.
- Un'entità IAM potenzialmente compromessa con privilegi di amministratore o comunque elevati.
- Più chiamate API riuscite con utenti IAM diversi dallo stesso indirizzo IP sconosciuto.
- Condivisione cross-account di un'immagine o di uno snapshot con un account sconosciuto.
- Un'istanza/VM potenzialmente compromessa dotata di privilegi IAM.
Quando li elenco, la maggior parte degli addetti all'incident response commenta: "ovvio, è banale", ma nella mia esperienza chi proviene dall'IR tradizionale ha bisogno di un po' di tempo per riconoscere questi problemi e rendersi conto che sono molto più critici di una macchina virtuale compromessa qualsiasi.
Nel cloud, "grave o non grave" si traduce quasi sempre in "è pubblico oppure si sono spostati nel management plane (IAM)".
Grave o non grave. Ogni volta che trovate un nuovo elemento di prova, un nuovo tassello del puzzle, passatelo al vaglio di questa domanda per capire se il paziente sta per collassare o se ha soltanto un raffreddore.
Fermare l'emorragia
Molti di voi avranno probabilmente seguito un corso di rianimazione cardiopolmonare e primo soccorso. Avrete imparato le "ABC": Airway, Breathing e Circulation (vie aeree, respirazione e circolazione).
Ebbene, si è scoperto che su quel punto avevamo sbagliato di grosso.
Gli studi hanno iniziato a mostrare che, in un'emergenza, le persone si concentravano sulle ABC perdendo di vista il quadro generale. Persino i paramedici si ritrovavano a praticare la rianimazione cardiopolmonare su qualcuno che stava dissanguandosi da una ferita alla gamba. A volte era una rianimazione perfetta. Lo si capiva dalla rapidità con cui il paziente restava senza sangue. Oggi anteponiamo il "trattare la minaccia per la vita" e "fermare l'emorragia" è la priorità assoluta.
Capite dove voglio arrivare?
In ogni corso che ho tenuto, vedo professionisti con grande esperienza concentrarsi sull'analisi e sull'indagine mentre il cloud si dissangua davanti ai loro occhi. Perché?
Perché non sono abituati al fatto che tutto sia (potenzialmente) su Internet. L'intero management plane è su Internet, quindi se un attaccante ottiene delle credenziali non potete fermarlo con un firewall o bloccando l'accesso a un server. Se qualcosa è compromesso ed esposto, è compromesso ed esposto a... beh, potenzialmente a tutti, ovunque, nello stesso momento.
Fermare l'emorragia va di pari passo con grave o non grave. Se trovate qualcosa di grave, dovete contenerlo subito, sul momento, prima di procedere? È un equilibrio delicato, perché se sbagliate la valutazione rischiate di sprecare tempo prezioso mentre l'attaccante continua ad avanzare. Fermare l'emorragia equivale a dire "la situazione è così grave che devo intervenire ora". Ma una volta fermata l'emorragia, dovete riprendere esattamente da dove eravate e proseguire con l'analisi e il processo di risposta, perché potrebbe esserci ancora molto altro in corso.
La mia lista essenziale?
- Qualsiasi entità IAM con privilegi elevati che appaia compromessa.
- Dati sensibili in qualche modo pubblici.
- Condivisione cross-account/subscription/project o accesso verso una destinazione sconosciuta.
C'è dell'altro, ma questa è la lista essenziale. Ognuno di questi casi indica una perdita di dati o una compromissione in corso e va contenuto immediatamente.
Un esempio pratico
Ecco un esempio. Gli screenshot sono un misto di Slack, console AWS e FireMon Cloud Defense. Questa è la mia toolchain, ma il procedimento funziona con qualsiasi strumento abbiate. Nei corsi di formazione usiamo anche query Athena per simulare un SIEM, ma voglio mantenere questo articolo (relativamente) breve.
Partiamo da un avviso di gravità media in Slack generato dalla nostra piattaforma combinata CSPM/CDR:
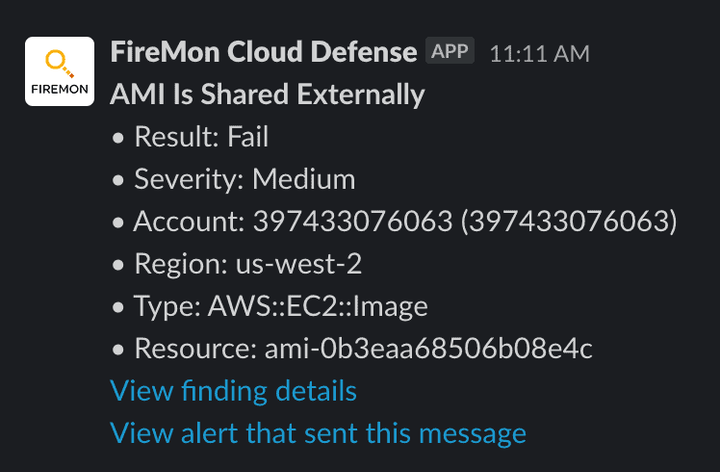
Grave o non grave? Non lo sappiamo ancora. Potrebbe essere del tutto legittimo. Bene, è il momento di indagare. Lo mostrerò sia nella piattaforma sia nella console AWS. Il mio primo passo è capire che cosa è condiviso e dove. Poiché l'avviso riporta l'ID dell'AMI, possiamo andarci direttamente:
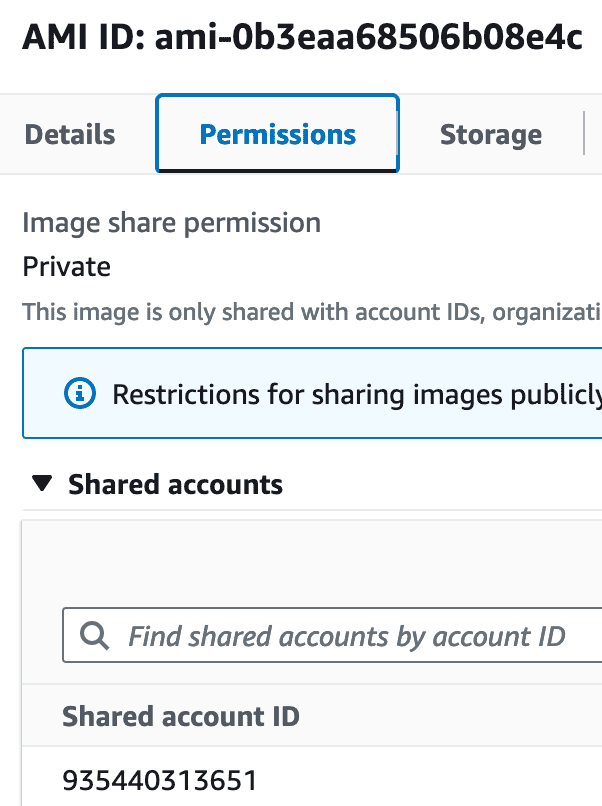
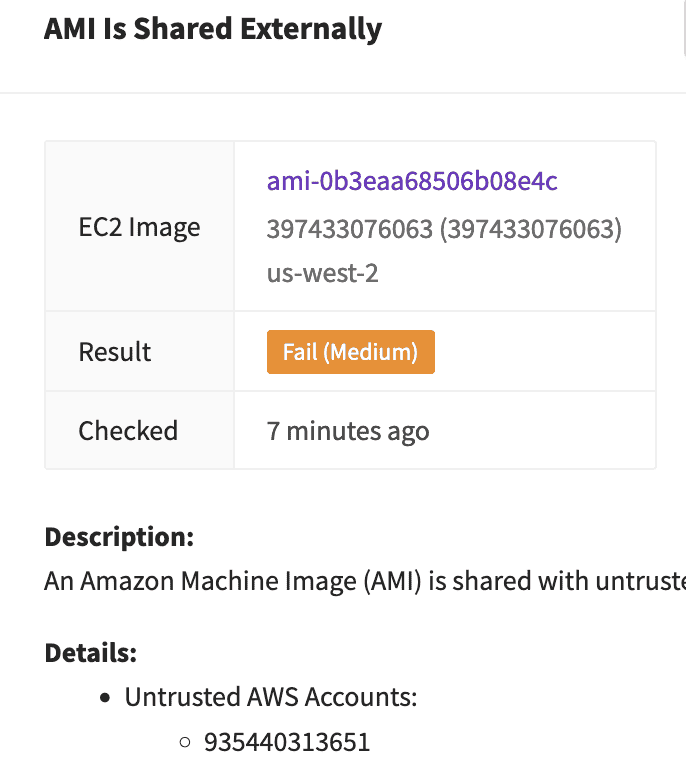
Bene: vedo che è condivisa con un altro account. È un account di mia proprietà? Un account che conosco? Il mio strumento lo segnala come non attendibile perché non è un account registrato nel sistema, ma nella realtà vorrei verificare l'elenco principale degli account della mia organizzazione, giusto per averne conferma.
Bene, grave o non grave? Nella mia testa è ancora un forse. Ho un'immagine condivisa con un account potenzialmente non attendibile. Ma non so ancora che cosa sia condiviso. Devo risalire all'istanza di origine. Non mi metto a fare un'analisi forense completa: mi affido alle informazioni di contesto, perché devo capirlo piuttosto in fretta. In questo caso siamo stati fortunati:
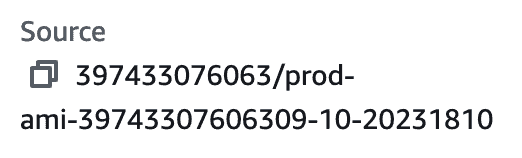
Ha "Prod" nel nome, quindi... lo classifico come "probabilmente grave". Fermare l'emorragia? Nella realtà proverei prima a contattare il proprietario di quell'account AWS, ma per oggi ritengo di avere informazioni sufficienti per mettere l'AMI in quarantena. Ecco come farlo nella console e in Cloud Defense:
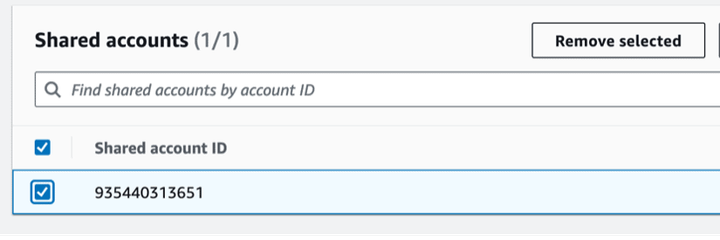
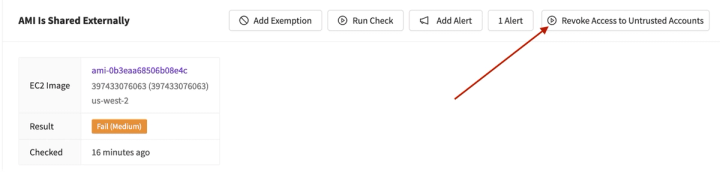
Bene, abbiamo fermato l'emorragia? Ne abbiamo fermata... una parte. Abbiamo bloccato l'AMI, ma non sappiamo ancora come sia finita lì. Non sappiamo nemmeno chi sia il proprietario di quell'account AWS. Possiamo scoprirlo? No. Se non è nostro, tutto ciò che possiamo fare è segnalarlo ad AWS e lasciare che se ne occupino loro.
Andiamo a caccia delle chiamate API per scoprire chi l'ha condivisa e che altro ha fatto. I passaggi successivi li eseguirò nella piattaforma, ma potreste ottenere le stesse informazioni con query nel vostro SIEM o in Athena. Dedicherò articoli futuri a tutte le query, mentre questo si concentra sui concetti di gravità ed emorragia.
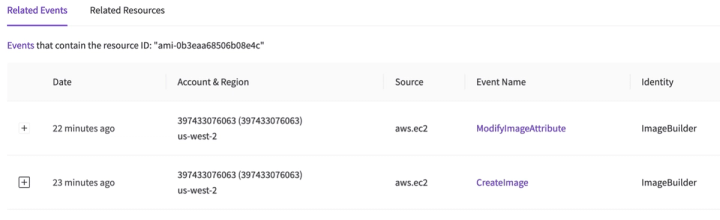
Bene: vedo che la responsabile è un'entità IAM denominata ImageBuilder. Anche qui, dato che l'articolo si sta già allungando, ho verificato alcune cose ed ecco che cosa ho scoperto:
- ImageBuilder è un utente IAM con privilegi per creare immagini e modificarne gli attributi, ma nulla di più. Tuttavia, la policy non ha vincoli sulle risorse, quindi può creare un'immagine di qualsiasi istanza. E non ha vincoli condizionali, quindi può condividerla con qualsiasi account. Il blast radius è da moderato a basso: i privilegi sono eccessivi, ma non in modo drammatico. Lo definisco "parzialmente grave".
- La chiamata API proveniva da un indirizzo IP sconosciuto. È sospetto, ma resta solo parzialmente grave.
- È la prima volta che vedo quell'indirizzo IP usato da questo utente IAM, e l'utente mostra un'attività precedente coerente con un processo batch. Bene, ora propendo per grave. Di solito non vediamo indirizzi IP che ruotano per lavori di questo tipo: sa di credenziale trafugata:
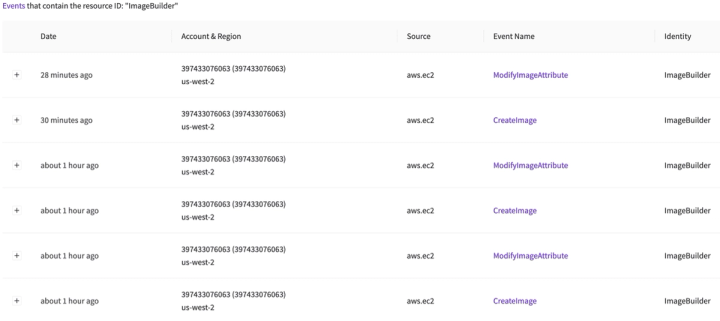
- Quell'utente IAM può continuare a eseguire queste azioni. A meno che qualcuno non mi dica che era un'operazione voluta, lo classifico come Grave e procedo a Fermare l'emorragia e ad applicare una restrizione IAM su quell'account utente (probabilmente una policy Deny All, a meno che non si tratti di un processo critico, nel qual caso userei una restrizione basata su IP).
In sintesi:
- Ho trovato un'AMI condivisa con un account sconosciuto: Grave
- Quell'AMI riguardava un asset di produzione: Grave e fermare l'emorragia
- L'azione proveniva da un utente IAM con ampi privilegi per creare AMI e condividerle, ma nulla di più: Forse grave, indagine ancora in corso.
- L'utente IAM ha creato quell'AMI da un indirizzo IP nuovo e sconosciuto: Grave, fermare (il resto del)l'emorragia.
- Non è stata rilevata alcuna altra attività proveniente dall'indirizzo IP: probabilmente contenuta e non più Sick
- Continuo a non sapere come siano trapelate quelle credenziali: Sick, ed è il momento di coinvolgere i nostri colleghi dell'IR tradizionale per capire se si è trattato di una compromissione di rete o di host.
Ho percorso rapidamente questi passaggi per illustrare come affronto tali problemi. Con poche differenze, questo stesso rilevamento sarebbe stato del tutto normale. Immaginiamo di aver capito che la condivisione riguardava un nuovo account sotto il nostro controllo ma non ancora registrato. Oppure che l'AMI fosse relativa a un'istanza di sviluppo priva di contenuti sensibili. Oppure che le chiamate API provenissero dalla nostra rete, nell'orario previsto, o dal sistema di un amministratore che intendeva effettuare la condivisione. Questo esempio non è eclatante, ma è una forma nota di esfiltrazione di dati utilizzata da threat actor attivi. Man mano che individuo ogni informazione, valuto se si tratta di Sick o Not Sick e se è necessario Stop the Bleed.
In che cosa il cloud è diverso? Perché la posta in gioco è più alta quando tutto è potenzialmente esposto a Internet. Dobbiamo pensare e agire più rapidamente, e trovo utile questo espediente mnemonico per mantenere la rotta.