洞察策略风险,用自然语言提问策略问题。 申请演示 →
Published:
薛定谔的错误配置
by FireMon
周四下午,您正准备早点下班,因为……您可以。但就在这时,那个烦人的"通知投递员"(也就是 Slack)在您的安全告警频道里弹出了一条新消息:
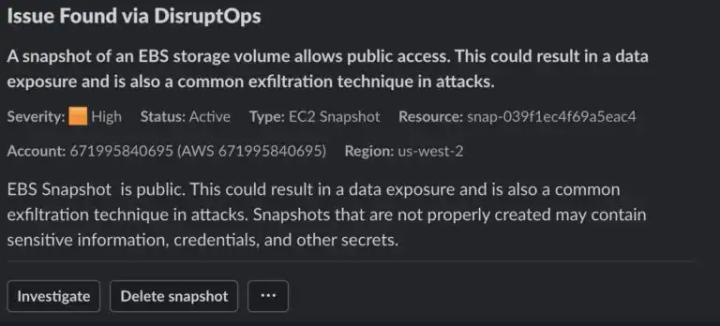
真糟糕。有人刚刚把一个存储卷的快照设为了公开。这是一次攻击?一个失误?还是某个并不了解策略规定的人所为?
错误配置有三种存在状态
我开始把这种情况称为薛定谔的错误配置,因为我有个坏习惯,总爱用量子力学原理来解释信息安全。如果您还不知道薛定谔的猫,我会非常吃惊——那是埃尔温·薛定谔用来向阿尔伯特·爱因斯坦阐释量子叠加悖论的著名思想实验。极简版本是这样的:如果您把一只猫关进一个盒子里,盒中有由放射性衰变触发的毒药,那么在您打开盒子查看之前,这只猫既不是活的也不是死的,因而处于同时既生又死的状态。
没错,这很荒谬,而这正是重点所在。对于我们这些养猫的人来说尤其如此,因为猫咪绝对不喜欢被困在盒子里。虽然我可以就"猫自己钻进盒子却在您把它放进盒子时大发脾气"写一整个系列的博客,而且……我扯远了。
回到云安全。这个思想实验背后的基本概念是:某个事物同时存在于多种状态之中,直到您去观察它,而观察这一行为迫使它给出一个确定的答案。当然,我为了自己的需要对它作了扭曲和简化,所以有物理学背景的读者请不要给我发愤怒的邮件。
这一概念在云上的版本是:任何一个错误配置都同时处于攻击、失误或策略违规的状态,直到您展开调查并确定其成因。
云有 5 个特征支撑着这一概念:
- 云团队/开发团队通常拥有更大的自主权,可直接管理自己的云基础设施。
- 云管理平面可通过互联网访问。
- (当前)云攻击最常见的来源是被盗的凭据。
- 许多错误配置所造成的状态与攻击者的行为完全一致(例如将快照设为公开)。
- 错误配置很容易在无意间产生,有时则是为满足某项需求而有意为之,但执行操作的人并未意识到这是一个安全问题。
这一概念在传统基础设施中同样成立,只是程度要轻得多,因为团队的自主权较小。应用程序的开发人员通常无法直接修改防火墙规则和路由表。而在云中,这种情况相当普遍,至少在某些环境中如此。
在证明并非如此之前,先假定为攻击
云端事件响应中一条较为重要的原则是:您绝对必须把错误配置当作安全事件来处理,并且在证明并非如此之前,假定它们就是攻击。
这是一种思维方式的转变,因为安全领域习惯于从漏洞和攻击面的角度思考问题,而我们把这些视为定期扫描的对象,并且在很大程度上当作有待修复的问题来处理。我的建议是,在云计算中,我们应把检测到的错误配置提升到与 IDS 或 EDR 告警同等的级别。它们不只是合规问题,它们是潜在的失陷指标。
当然,这并不适用于每个环境中的每一个错误配置。我们必须筛选并划分优先级。更好的做法是,我们必须沟通,因为要判断一个错误配置是否属于恶意攻击,通常最简单的方法就是直接询问做出该变更的人是否有意为之。
由于我必须为培训课程把内容提炼精简,我总结出了安全遥测数据的三类主要来源:
- 日志
- 云服务商事件(例如 Security Hub 事件)
- 云错误配置,可来自您的 CSPM 工具、OSS 扫描器或类似来源
大多数从事云安全工作的人已经内化了这一概念,但我们并不总是把它讲清楚。如果您看看一些云检测与响应(CDR)工具,会发现它们会针对某些错误配置生成告警。这与 CSPM 工具默认在报告和仪表板中生成发现项的模式不同。那些发现项对合规和整体安全卫生很重要,但由于攻击者会做出诸如向其他账户共享磁盘镜像或为 IAM 角色植入后门之类的恶劣行为,因此在证明并非如此之前,确实有一部分错误配置需要被当作失陷指标来对待。
在内部(以及在 DisruptOps 平台中),我们通过一组实时威胁检测器来处理这一问题,它们会根据识别出的 API 调用触发评估。识别一个错误配置并通过 Slack(或 Teams)将其发送给安全团队和项目负责人大约需要 15-30 秒,就像您在上面看到的那样。这些告警与 GuardDuty 发现项或任何其他失陷指标同等对待,但借助 ChatOps 来验证操作行为,也帮助我们极快地完成分级处置,而无需每次都进行深度分析。
简而言之,建议如下:以近乎实时的方式处理关键的云错误配置,并在证明并非如此之前,将其视为失陷指标。
在撰写本文的过程中,没有任何猫受到伤害。